DeepSeek V4 的 agent harness 对比:codex、claude code、pi、hermes、opencode
DeepSeek V4 Flash 在 7 月 31 日出了正式版(0731),我最关心的不是跑分,而是它终于能拿来干活了。按模型卡上的数据,Terminal Bench 2.1 从预览版的 61.8 涨到 82.7,DeepSWE 从 7.3 涨到 54.4。一个很便宜的模型,agentic 能力一下子上来了,接下来的问题就变成:把它接进哪个 harness(模型外面那层负责上下文、调用工具、执行任务的框架)。
这篇记录我当时的选型过程,以及后来又出了哪些新数据。
当时的情况
DeepSeek 官方的这些 agentic 分数,是用自家的 DeepSeek Harness 跑出来的,但 0731 发布时这个 harness 还没有公开。所以想用,只能从现有的开源 harness 里挑。
各家怎么接
Codex:模型列表里默认只有 OpenAI 自家的。接 DeepSeek 要在配置里加一个自定义的 model provider,指向 DeepSeek 兼容 OpenAI 的接口,用 API key 认证,ChatGPT 的登录态用不了。能用,但比较绕,而且 Codex 的交互习惯是按自家模型调的。
Claude Code:官方不支持 DeepSeek,要靠社区的代理方案把请求转给 DeepSeek。能用,但中间多了一层代理,出问题时要多排查一处。
OpenCode:社区接 DeepSeek 时最常被推荐的,第三方模型接起来比较顺。
Hermes:我服务器上常驻的 agent 用的就是它(安装过程写在另一篇里),接 DeepSeek 没什么障碍。
Pi / Oh My Pi:我写代码现在用的。配置简单,还能给不同的任务指定不同的模型,比如主要的活交给 DeepSeek,看图和搜索交给别的模型。
两份评测,结论不太一样
选型时我看了两份评测,它们的结论乍看是矛盾的。
第一份是 Nawk 的对比,用 DeepSeek V4 Flash 在一个大代码库里修 8 个 bug,比较了四个 harness:
| harness | 每轮固定开销(tokens) | 平均输出 tokens | 平均耗时 | 平均质量(0–3) |
|---|---|---|---|---|
| Pi | 1,340 | 14,775 | 2.1 分钟 | 2.34 |
| OpenCode | 7,197 | 17,463 | 3.1 分钟 | 2.07 |
| Claude Code | 23,132 | 58,370 | 8.0 分钟 | 2.42 |
| Nanocoder | 6,121 | 55,844 | 5.2 分钟 | 2.25 |
作者的结论是,质量上看不出哪个更好,差别全在开销和耗时上:Claude Code 每个任务要调用 59 到 70 次工具,Pi 是 35 到 38 次,多探索了很多,分数却没高多少。不过作者自己也提醒,每种条件只跑了很少几次,样本太小。
第二份是 Composio 的评测,同样用 DeepSeek V4 Flash,但任务不一样:30 个要调用 Gmail、GitHub、Slack 等真实应用的 agent 任务。它先发了四个 harness 的对比:
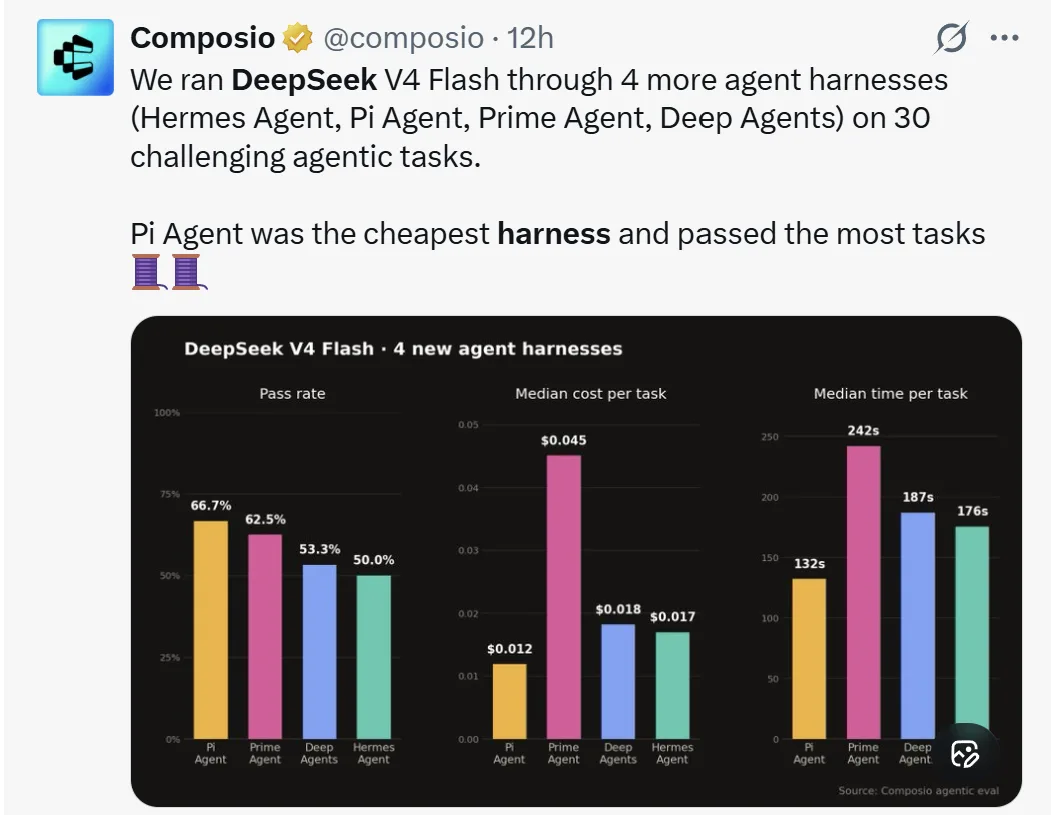
| harness | 通过率 | 单任务成本(中位数) | 单任务耗时(中位数) |
|---|---|---|---|
| Pi Agent | 66.7% | $0.012 | 132s |
| Prime Agent | 62.5% | $0.045 | 242s |
| Deep Agents | 53.3% | $0.018 | 187s |
| Hermes Agent | 50.0% | $0.017 | 176s |
后来又补全到 8 个 harness,按 30 个任务里通过的数量排:
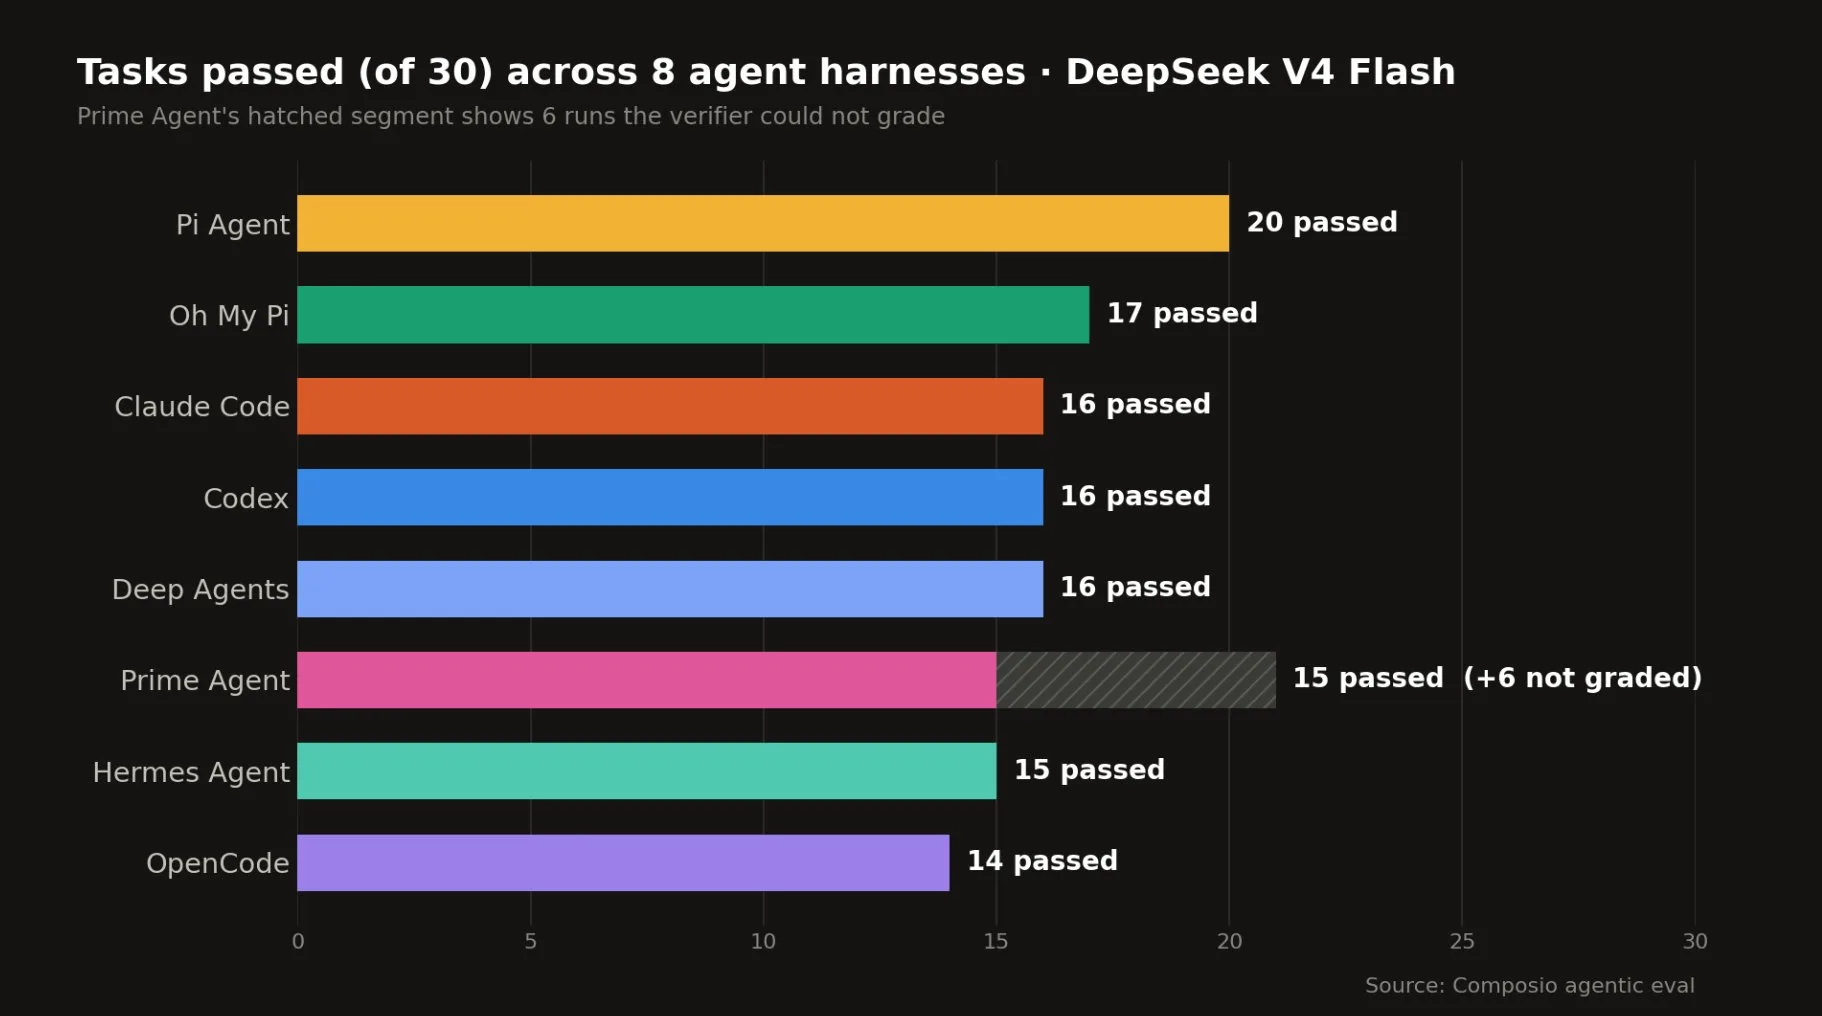
- Pi Agent:20
- Oh My Pi:17
- Claude Code、Codex、Deep Agents:各 16
- Prime Agent:15(另有 6 次无法评分,按 24 次有效计是 62.5%)
- Hermes Agent:15
- OpenCode:14
这一份里,同一个模型换个 harness,通过的任务数能差 6 个。Composio 自己的结论也是 harness 会明显影响成本、速度和可靠性。
两份放在一起看,我的理解是:修 bug 这种纯写代码的任务,harness 主要影响效率;要来回调用很多外部工具的任务,harness 连成功率都会影响。而 Pi 在两份评测里都是最省的,在第二份里通过率还是最高的。
Pi 一家
评测里有三个名字其实是一家:Pi、Oh My Pi 和 Prime Agent。后两个都是从 Mario Zechner 的 Pi(pi-mono)分出来的,都是 MIT 协议。
- Pi:原版,一个很精简的终端编码 agent,是这一系的源头。
- Oh My Pi(omp):Can Boluk 维护的分支,在原版基础上加了很多东西,比如 LSP 和调试器集成、子 agent、记忆系统,底层有不少用 Rust 重写。功能是这一家里最全的。
- Prime Agent:Prime Intellect 做的分支,路线完全不同,围绕一个常驻的 Python 内核和递归的子 agent 设计,偏向长时间自主运行的任务。它在 Composio 评测里有 6 次无法评分,我猜和这类任务的输出形式有关,但评测里没有说明原因。
我的选择
最后我用的是 Oh My Pi:DeepSeek V4 Flash 做主要的活,GPT-5.6 Luna 负责看图和搜索。
选它的理由很简单:Pi 这一系在两份评测里都是最省的,Oh My Pi 在第二份里排第二,而日常写代码用得上的功能它最全。harness 省下来的开销,可以花在更聪明的模型调用上。
还有一个前提不能忘:这些都建立在 0731 本身能干活的基础上。预览版的 DeepSWE 只有 7.3,那时候换哪个 harness 都没用。先确认模型能干活,再去比 harness。
后来:DeepSeek 自己的 harness 发布了
8 月 13 日,DeepSeek 和 V4 Pro 一起发布了自家的 DeepSeek Harness。Composio 用 V4 Pro 把它和 Pi 对比了一次,30 个任务:
| Pi | DeepSeek Harness | |
|---|---|---|
| 通过 | 21/30 | 20/30 |
| 单任务耗时(中位数) | 362.9s | 252.1s |
| 平均消耗 tokens | 924,990 | 88,562 |
通过数几乎一样,但 DeepSeek Harness 用的 token 只有 Pi 的十分之一左右,速度也快不少。Composio 作者的结论是日常写代码还是选 Pi,偏基础设施类的工作可以考虑 DeepSeek Harness。
我自己也试了 DeepSeek Harness。它的好处是看得很清楚:当前的生成速度(token/s)、每一次请求和响应的各个环节,都有图表展示。但用下来,我没有明显感觉到质量上的提升,速度反而比 Oh My Pi 慢一些,和上面评测里的耗时对不上。我用的是它刚发布时的早期版本,可能和这个有关。目前我还是用 Oh My Pi。