使用n8n实现AI文章工作流
我平时会在自己的网站上写文章。有一类文章是固定套路:给一个标题,让 AI 生成一篇结构化的内容,再存进数据库。每次手动走一遍很无聊,我就想把它自动化。
之前工作时我做过开源任务调度框架 DolphinScheduler 的二次开发,对节点和工作流这套概念不陌生。第一次用 n8n,最大的感受是它把各种社交平台、SaaS 和 AI 服务的接口都封装成了现成的节点,胶水代码基本不用写,调 AI、解析结果、写数据库,一个工作流就能串起来。这篇记录我搭的文章生成工作流:输入一个标题,生成文章,存进 Supabase。
工作流总览
整个工作流由六个节点组成:
- 对话触发(Chat Trigger):接收输入的标题
- AI Agent:按固定的 prompt 生成文章
- AI 模型:实际执行生成的模型
- 输出格式化:用 JSON Schema 约束 AI 输出的结构
- Code:从结果里取出 JSON,补上必填字段
- Supabase:把文章写进数据库
分步搭建
打开 n8n 官网,注册登录,创建一个新的工作流:
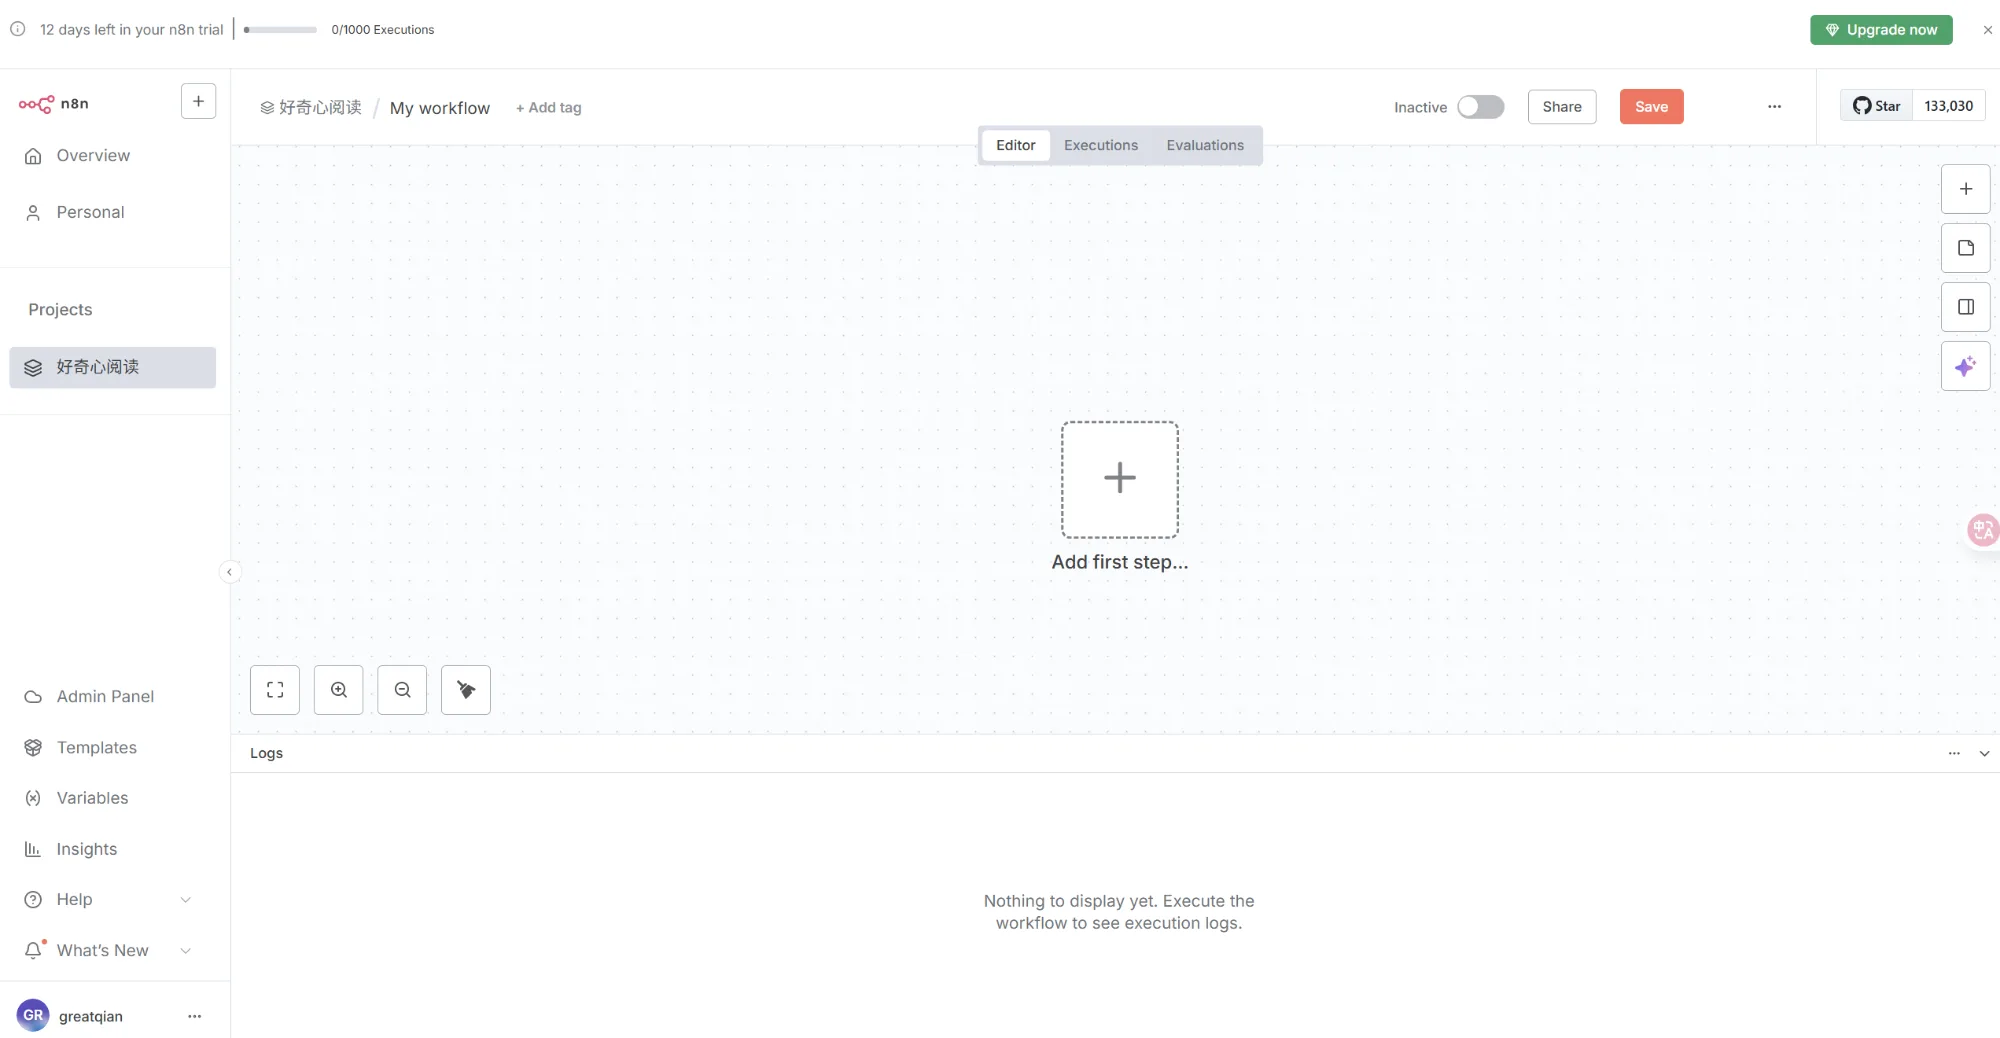
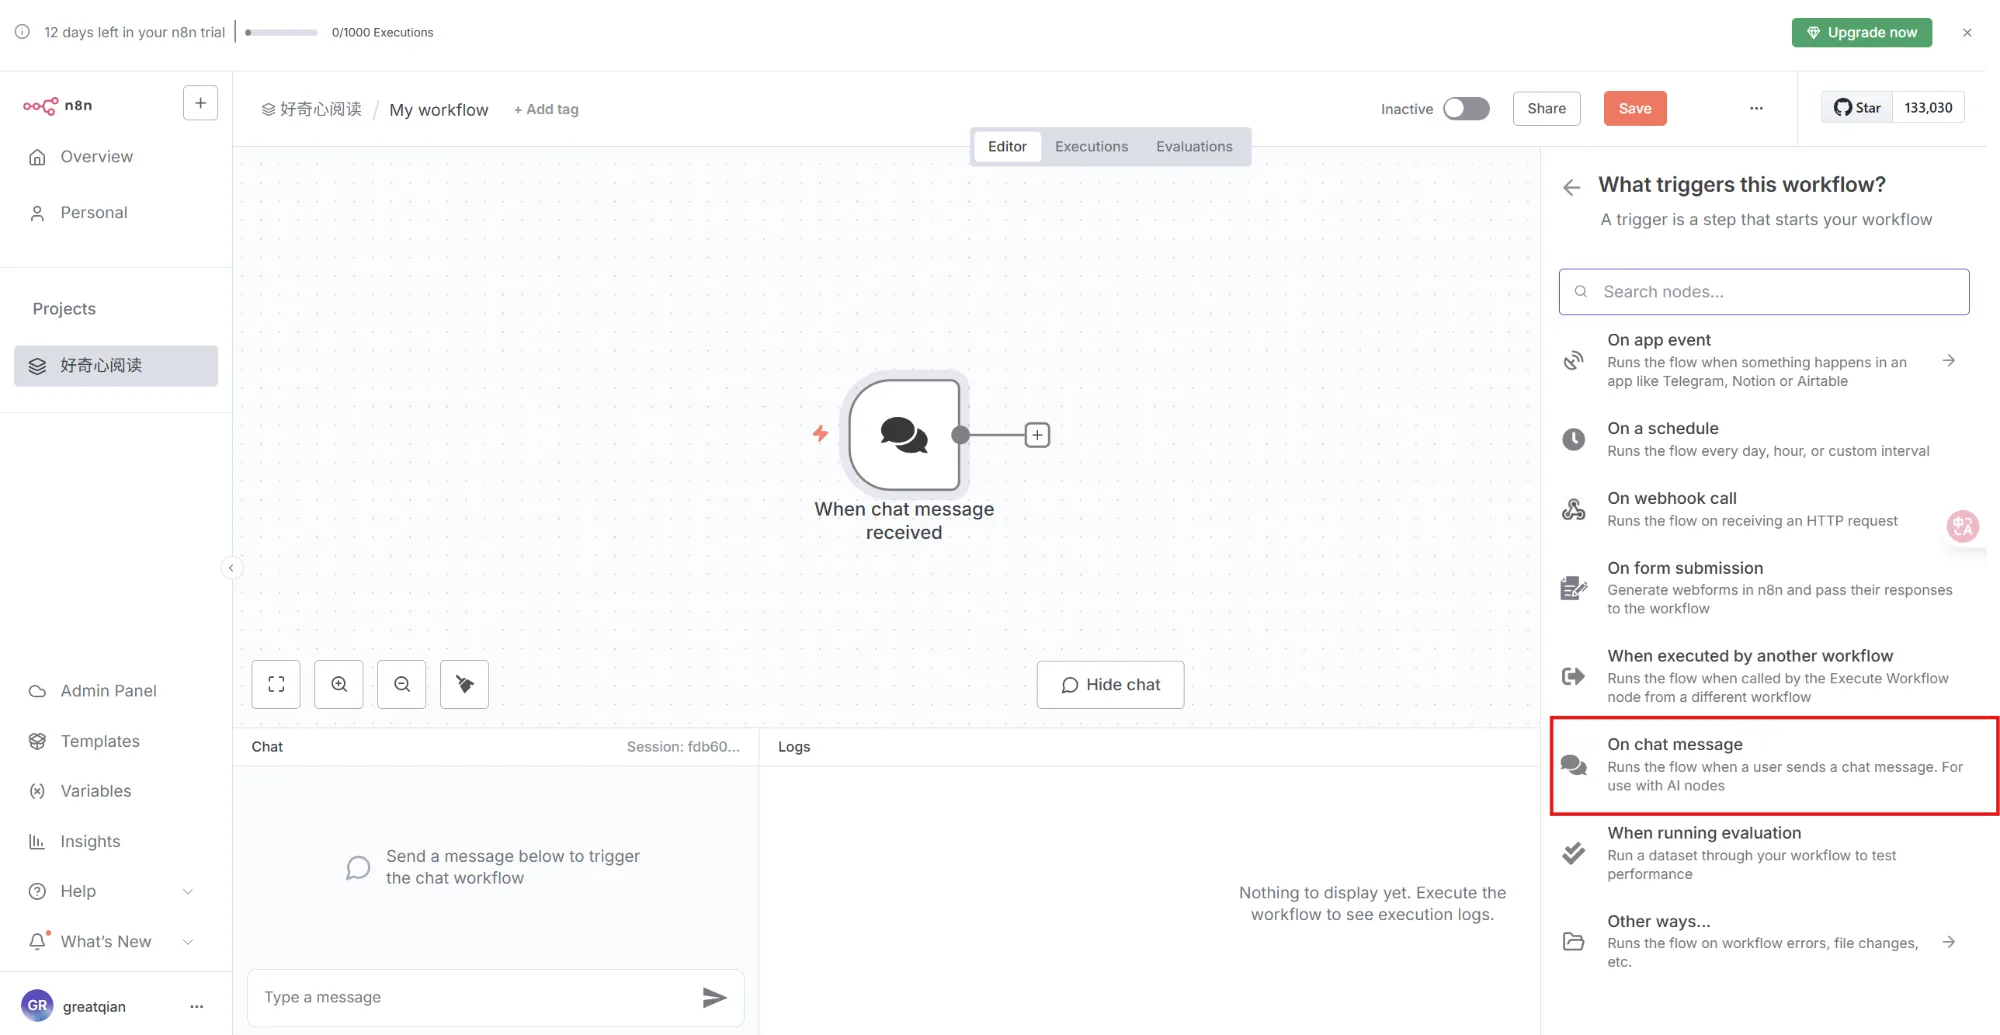
先添加一个对话触发节点。工作流从它开始,运行时要先输入一条消息,这条消息就是文章标题:
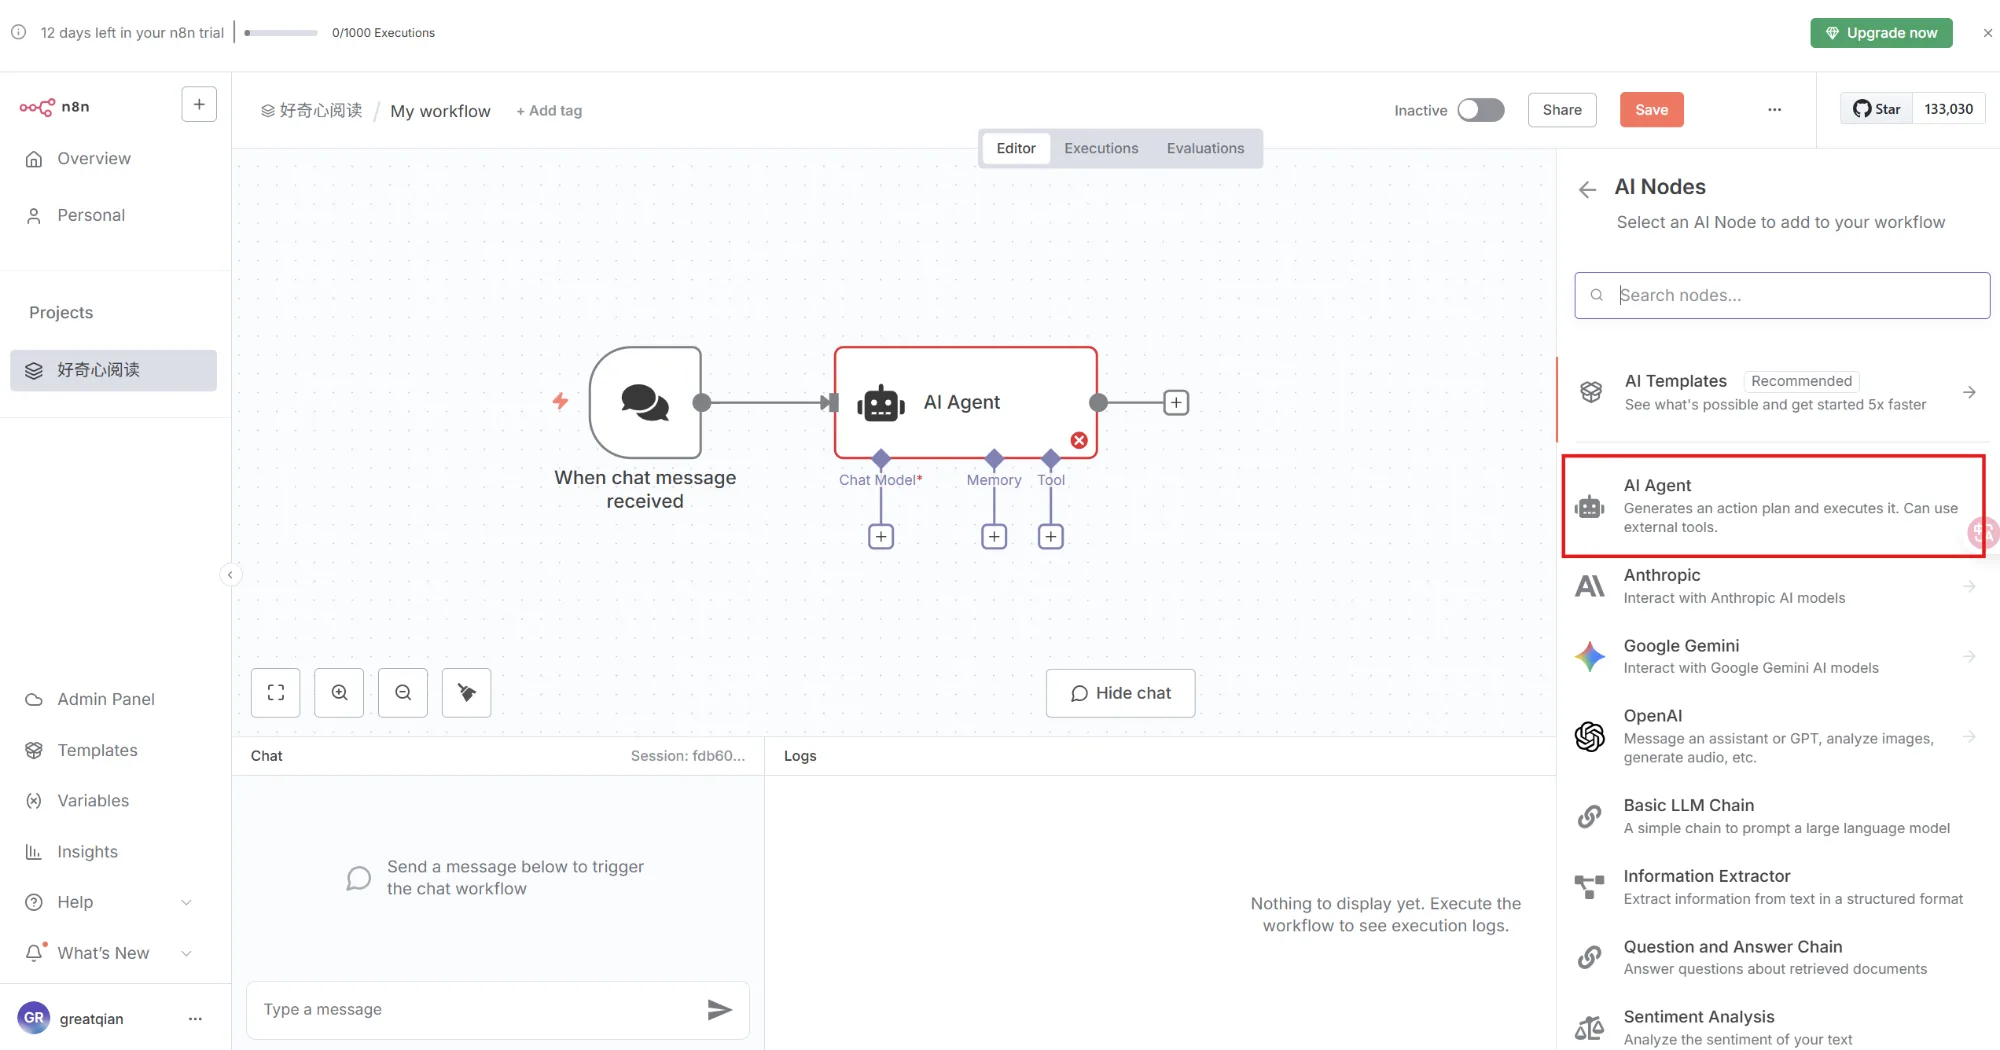
后面接一个 AI Agent 节点:
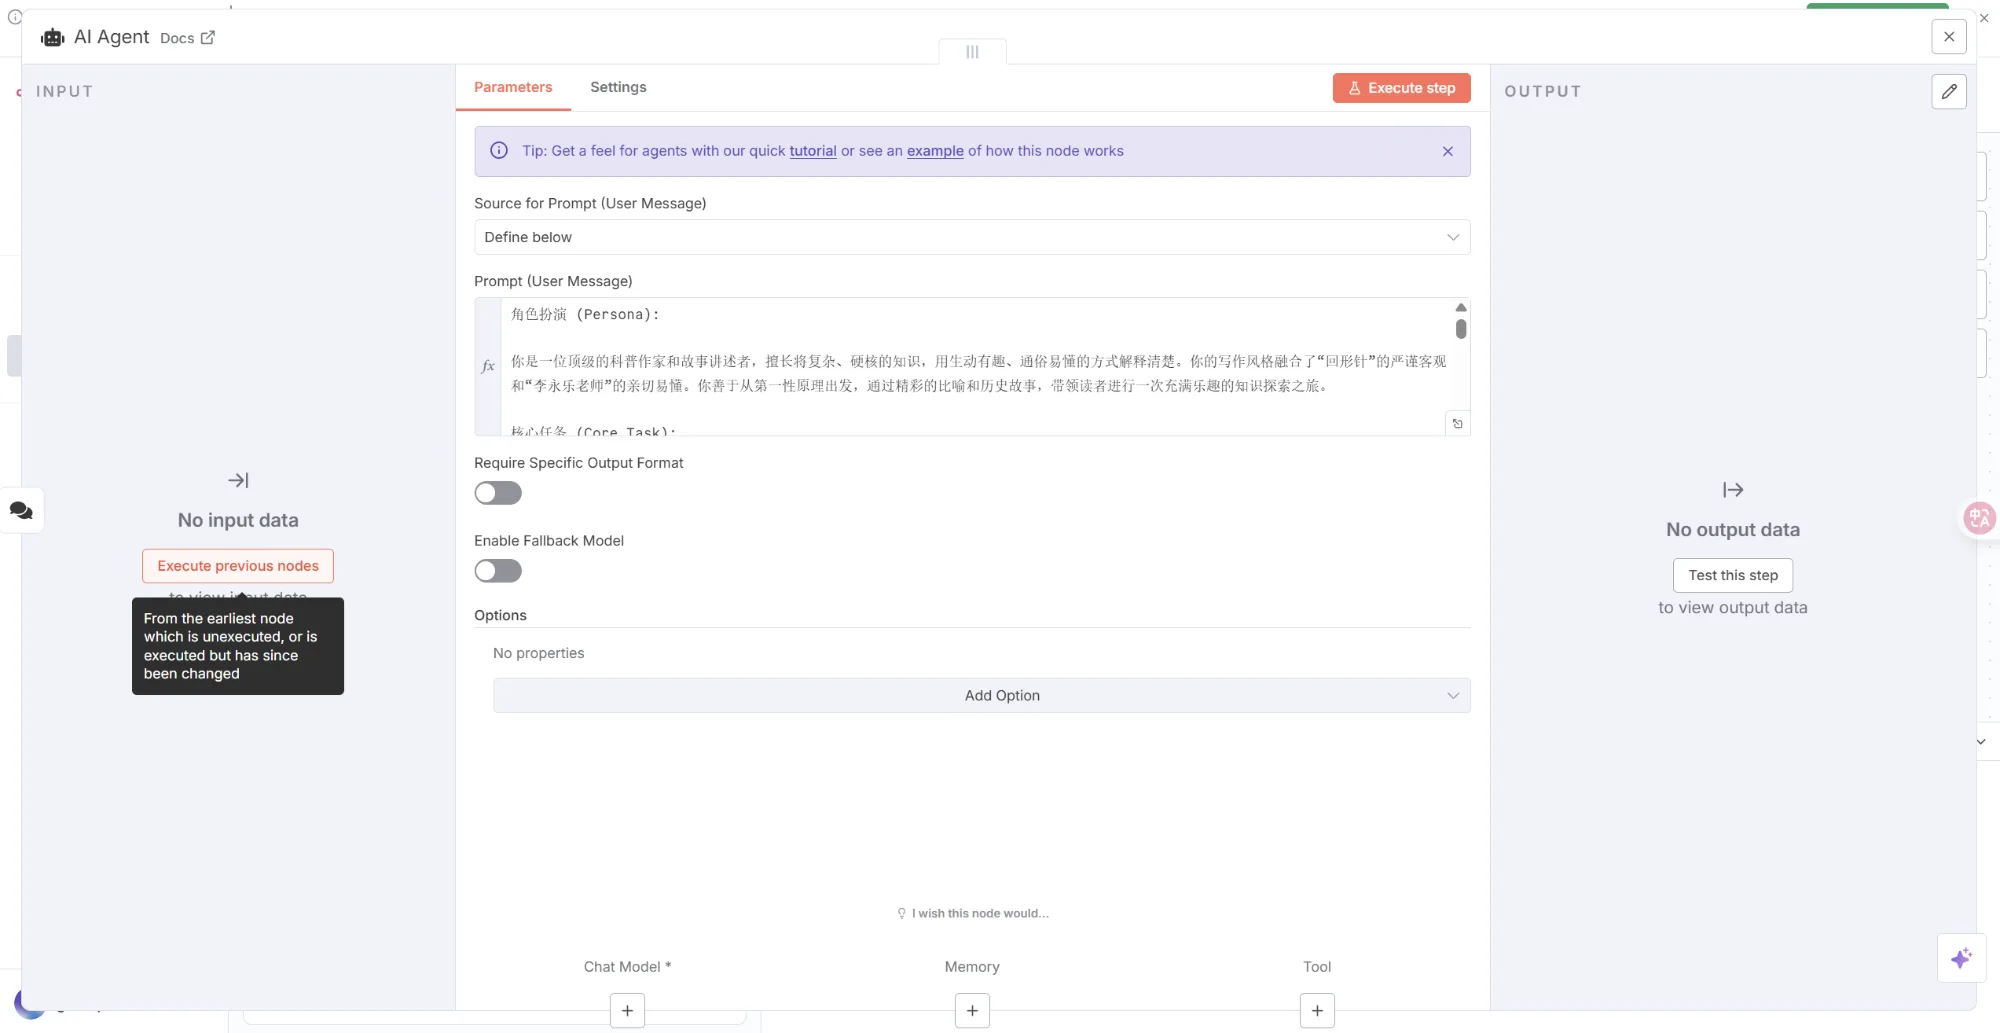
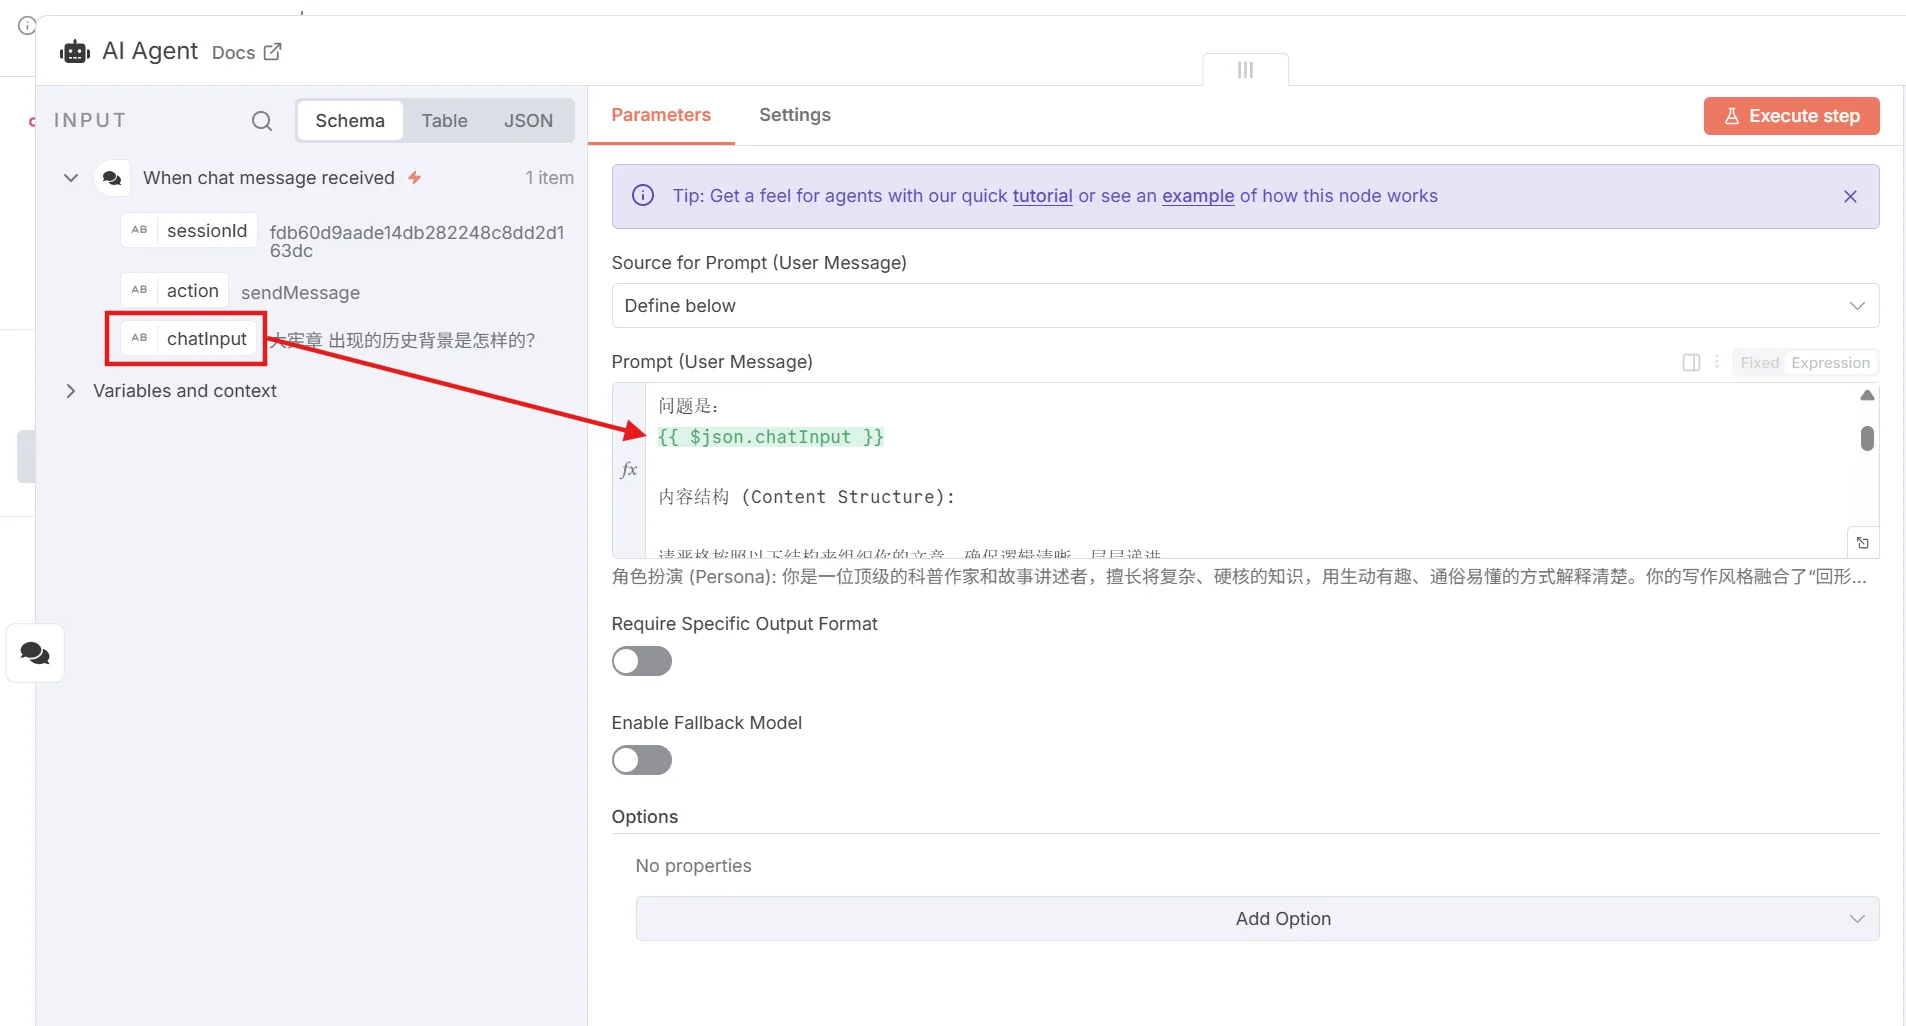
双击 AI Agent 节点打开配置。文章生成的 prompt 基本是固定的,所以 Source for Prompt (User Message) 选 Define below,把生成指令写进 Prompt 栏。prompt 里要用到标题,而标题来自上一个节点。这里有个小技巧:先点 execute previous node,把上一个节点执行一次,当前节点才能拿到上游的数据:
执行完之后,上游节点的参数就能在表达式里引用了。比如把 chatInput(触发节点收到的标题)拖进 prompt:
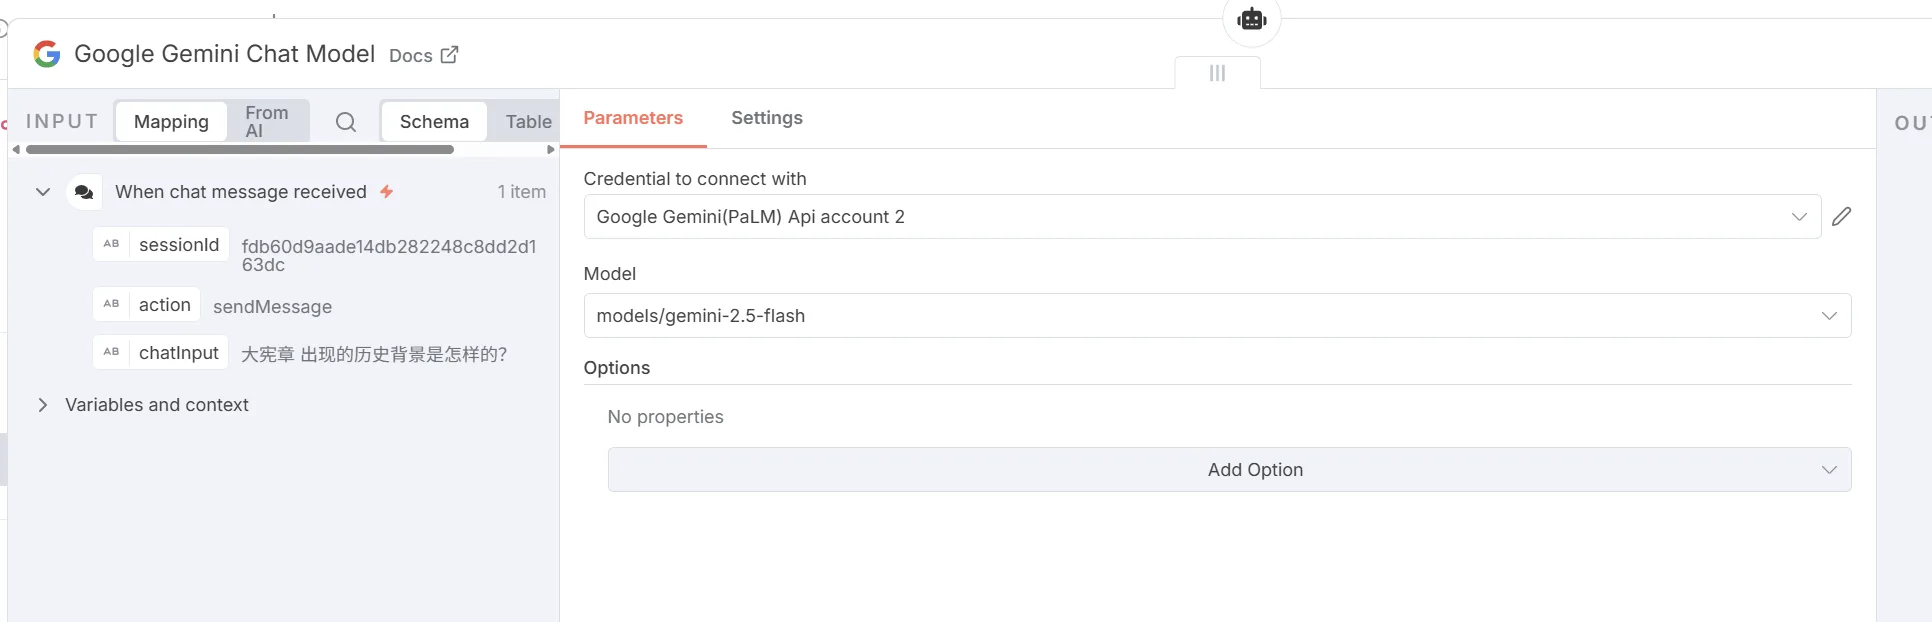
然后是 AI 模型节点,选择要用的模型并配置 API key:
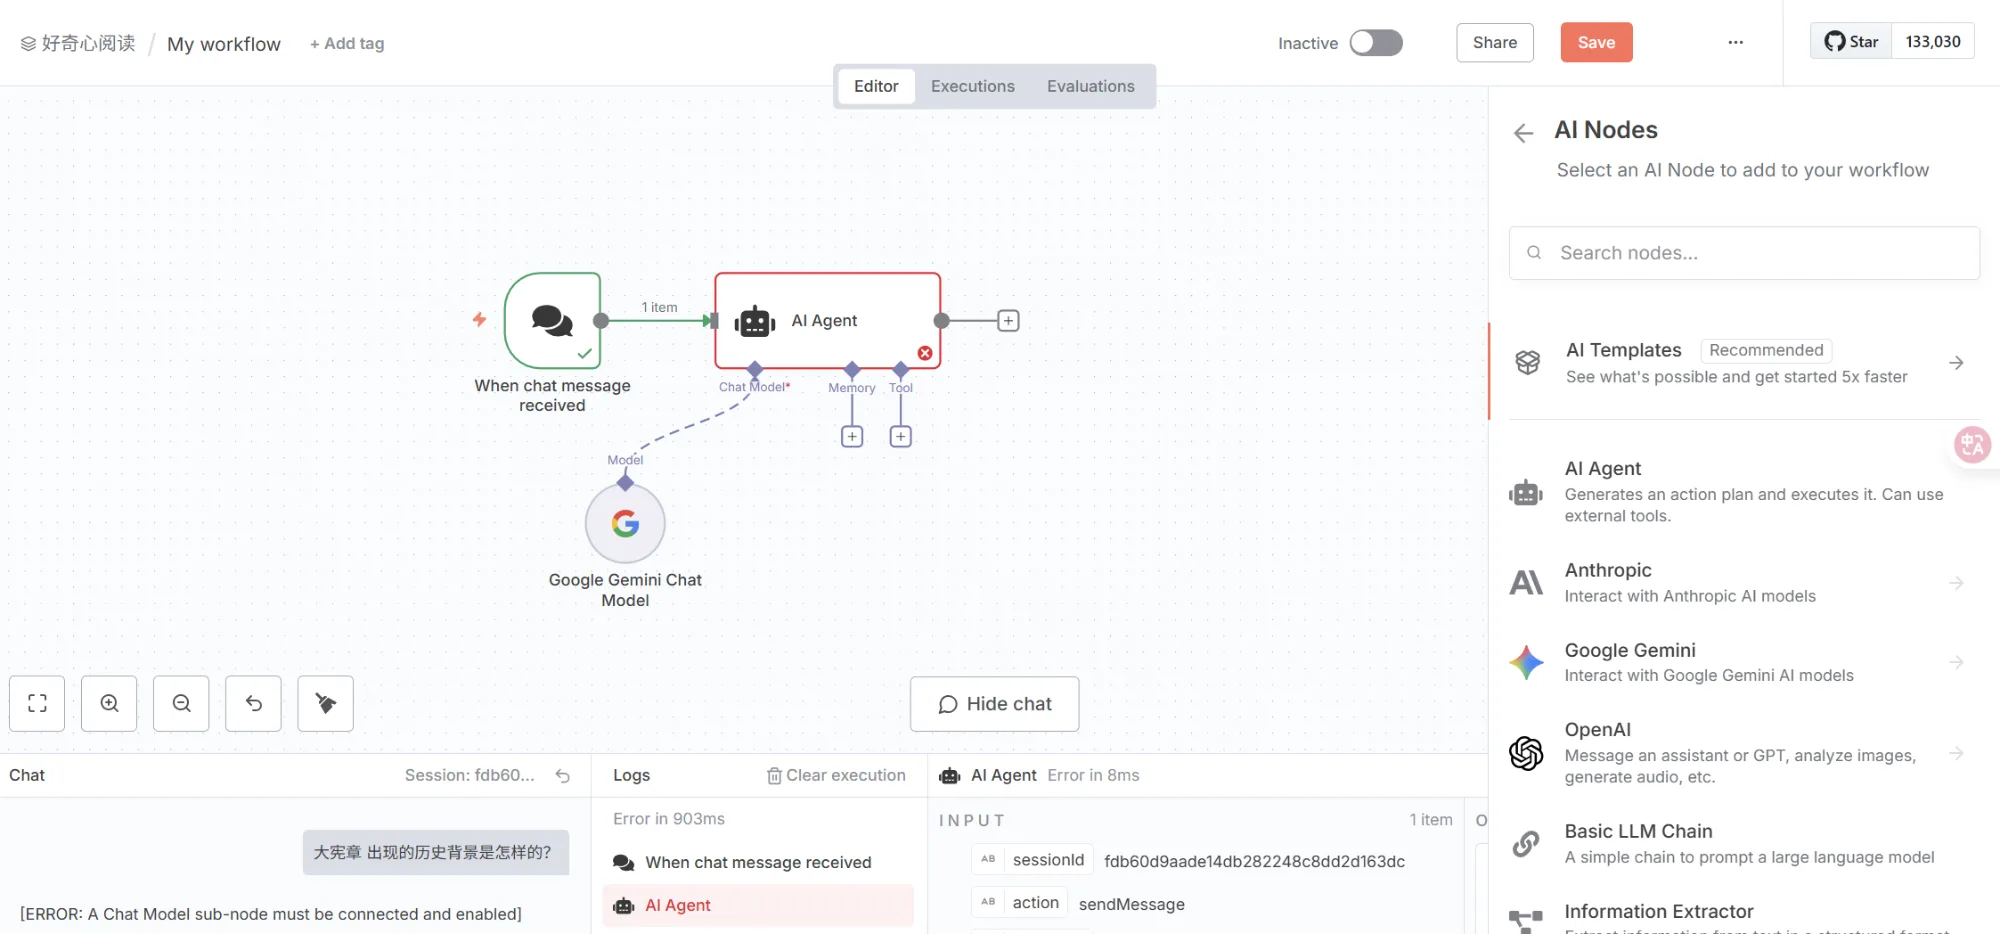
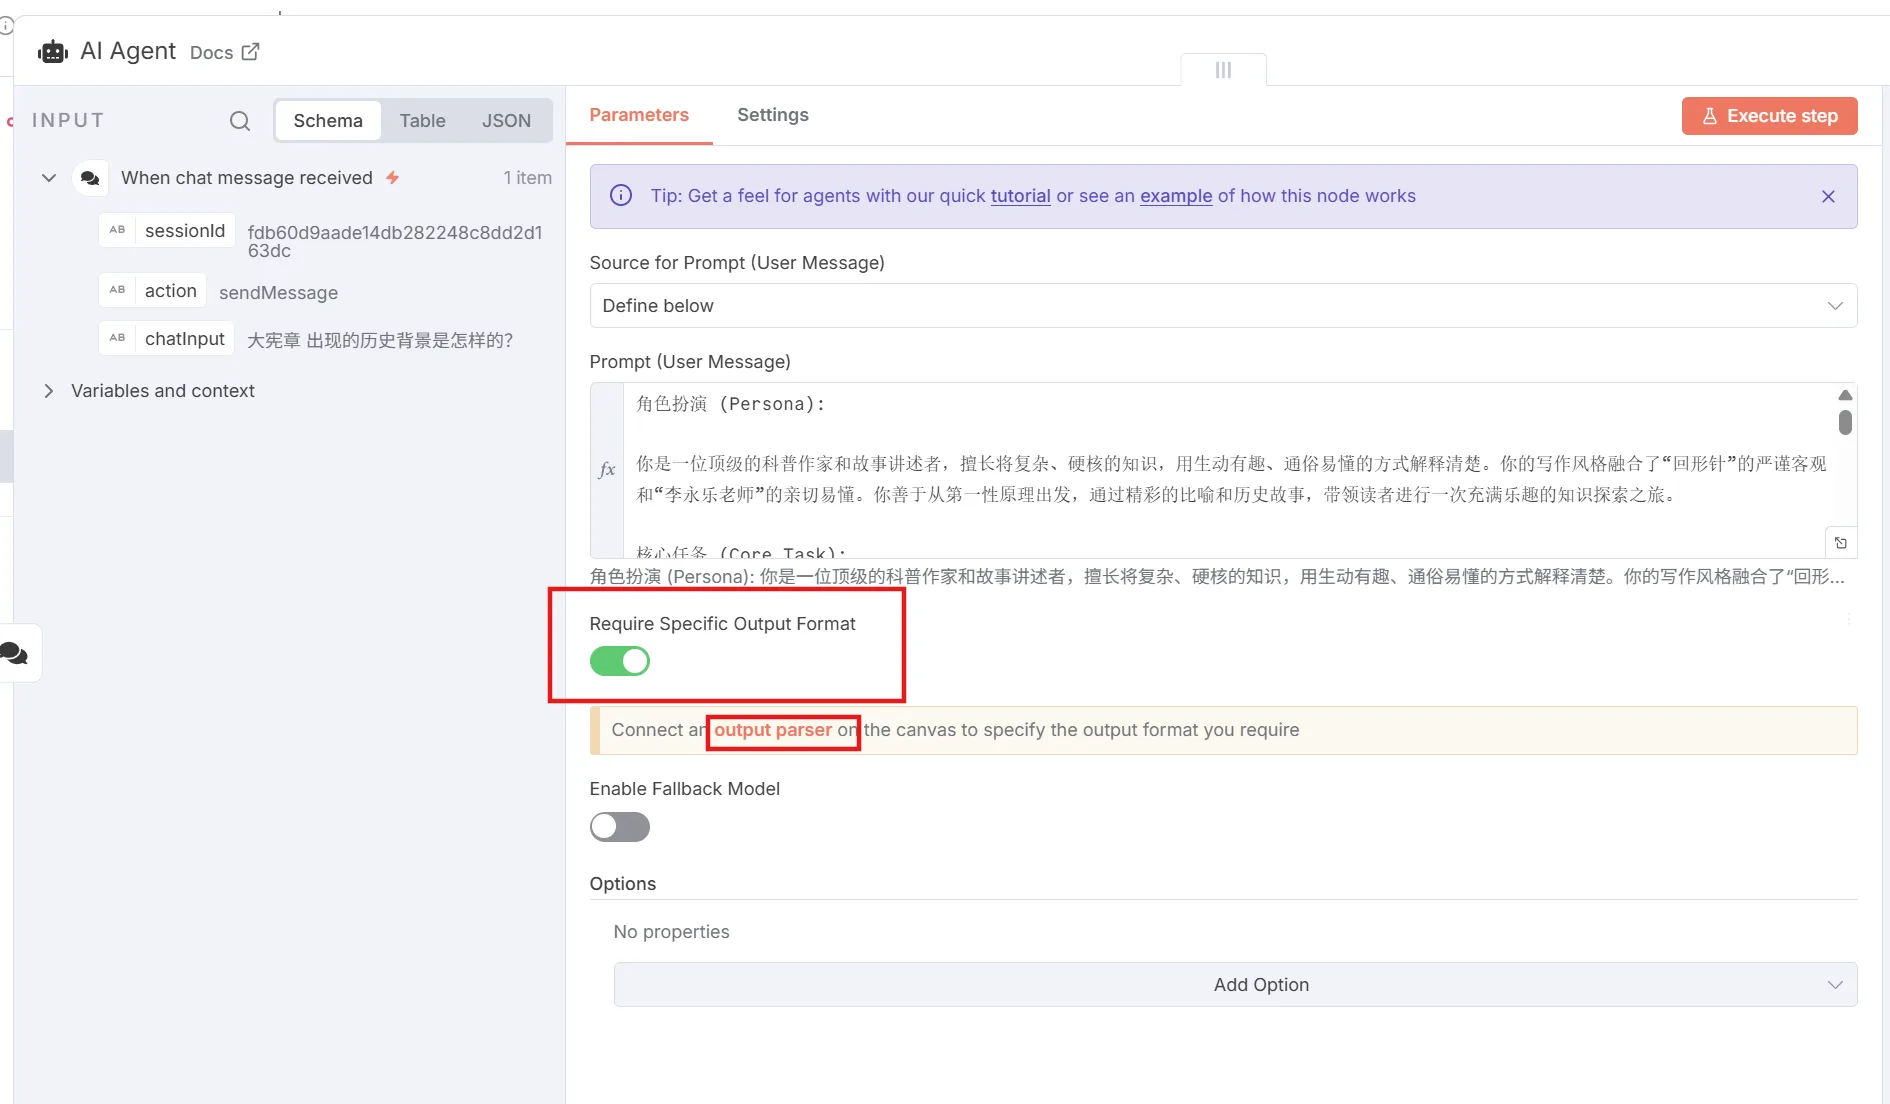
为了让 AI 输出 JSON 格式的结果、方便后续解析,开启输出格式化选项,然后点击 output parse 创建一个格式化节点:
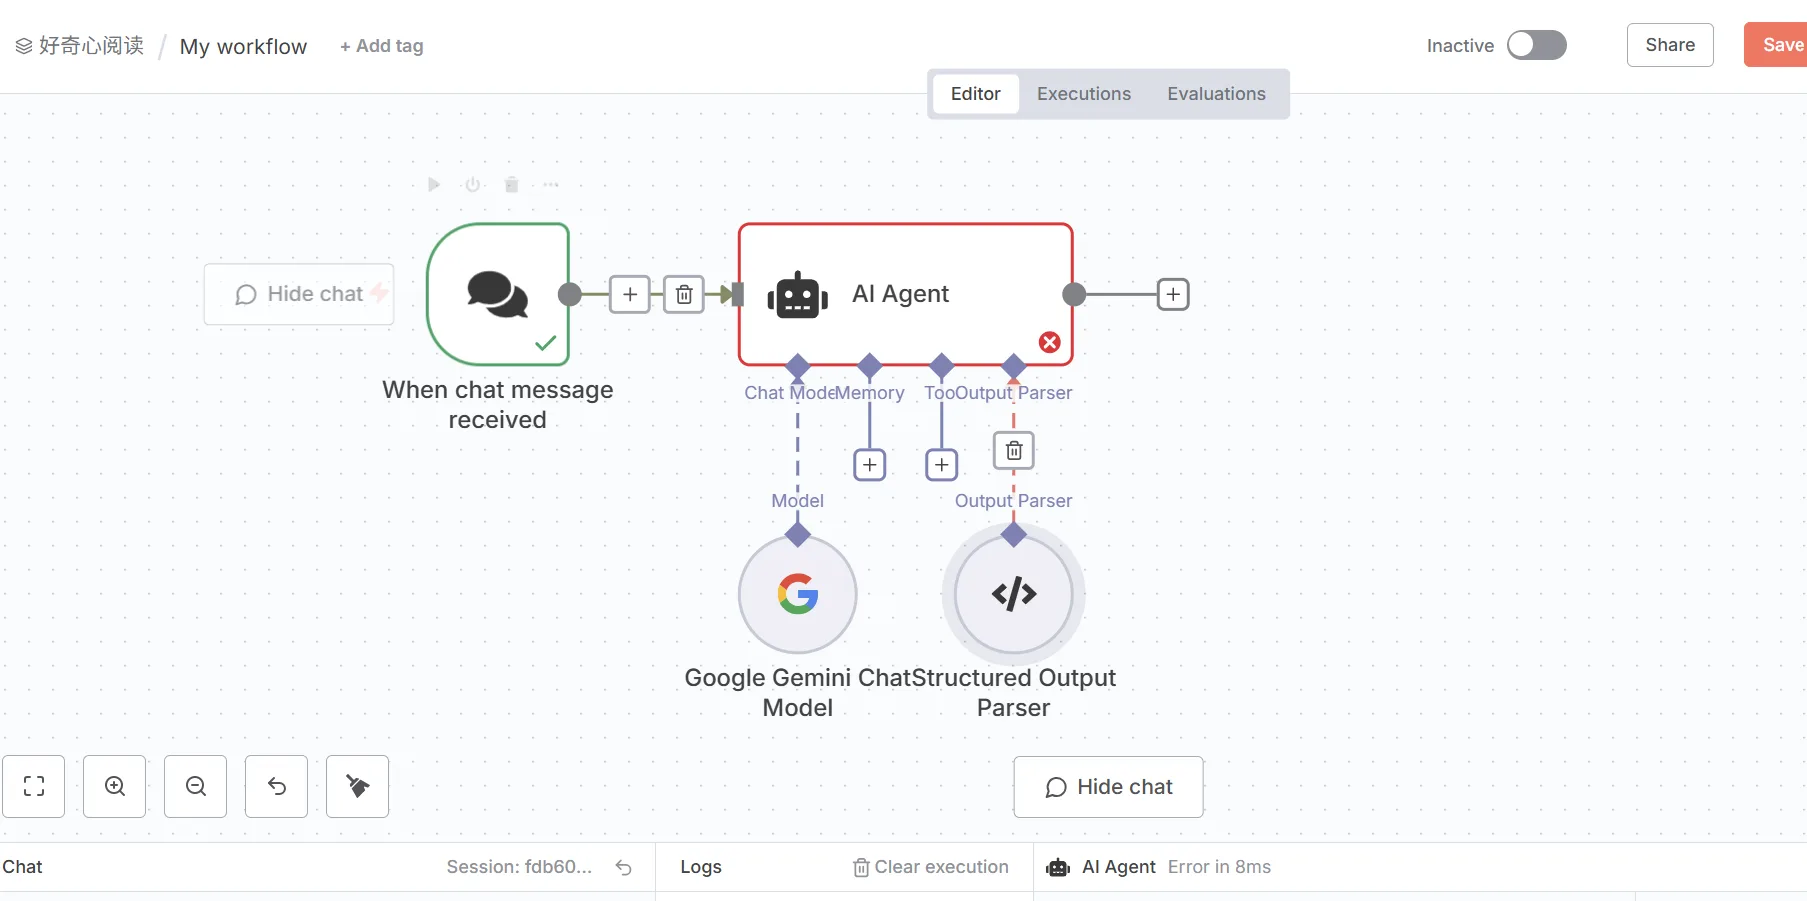
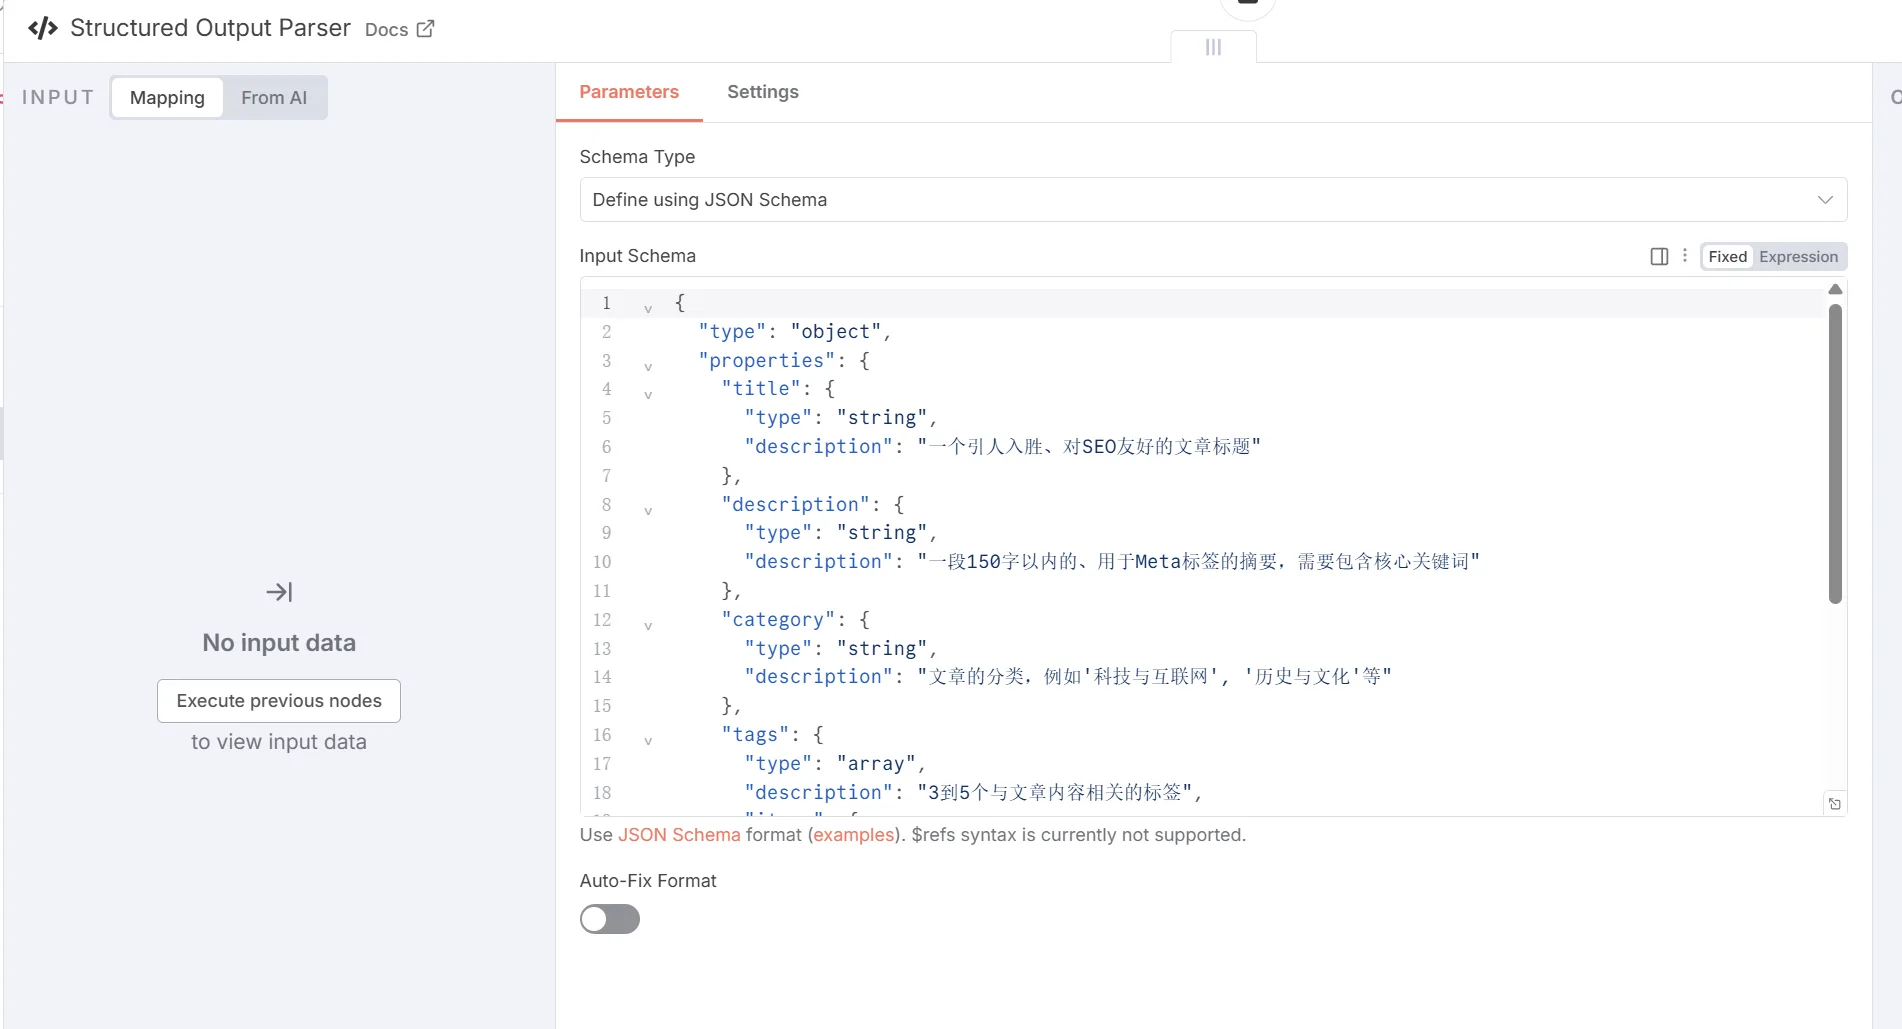
格式化节点里,Schema Type 选 Define using JSON Schema,定义输出结构。Schema 要和目标数据表的结构对齐,比如 posts 表存标题和正文,schema 就写成:
{
  "type": "object",
  "properties": {
    "title": { "type": "string", "description": "文章标题" },
    "content": { "type": "string", "description": "文章正文,markdown 格式" }
  },
  "required": ["title", "content"]
}
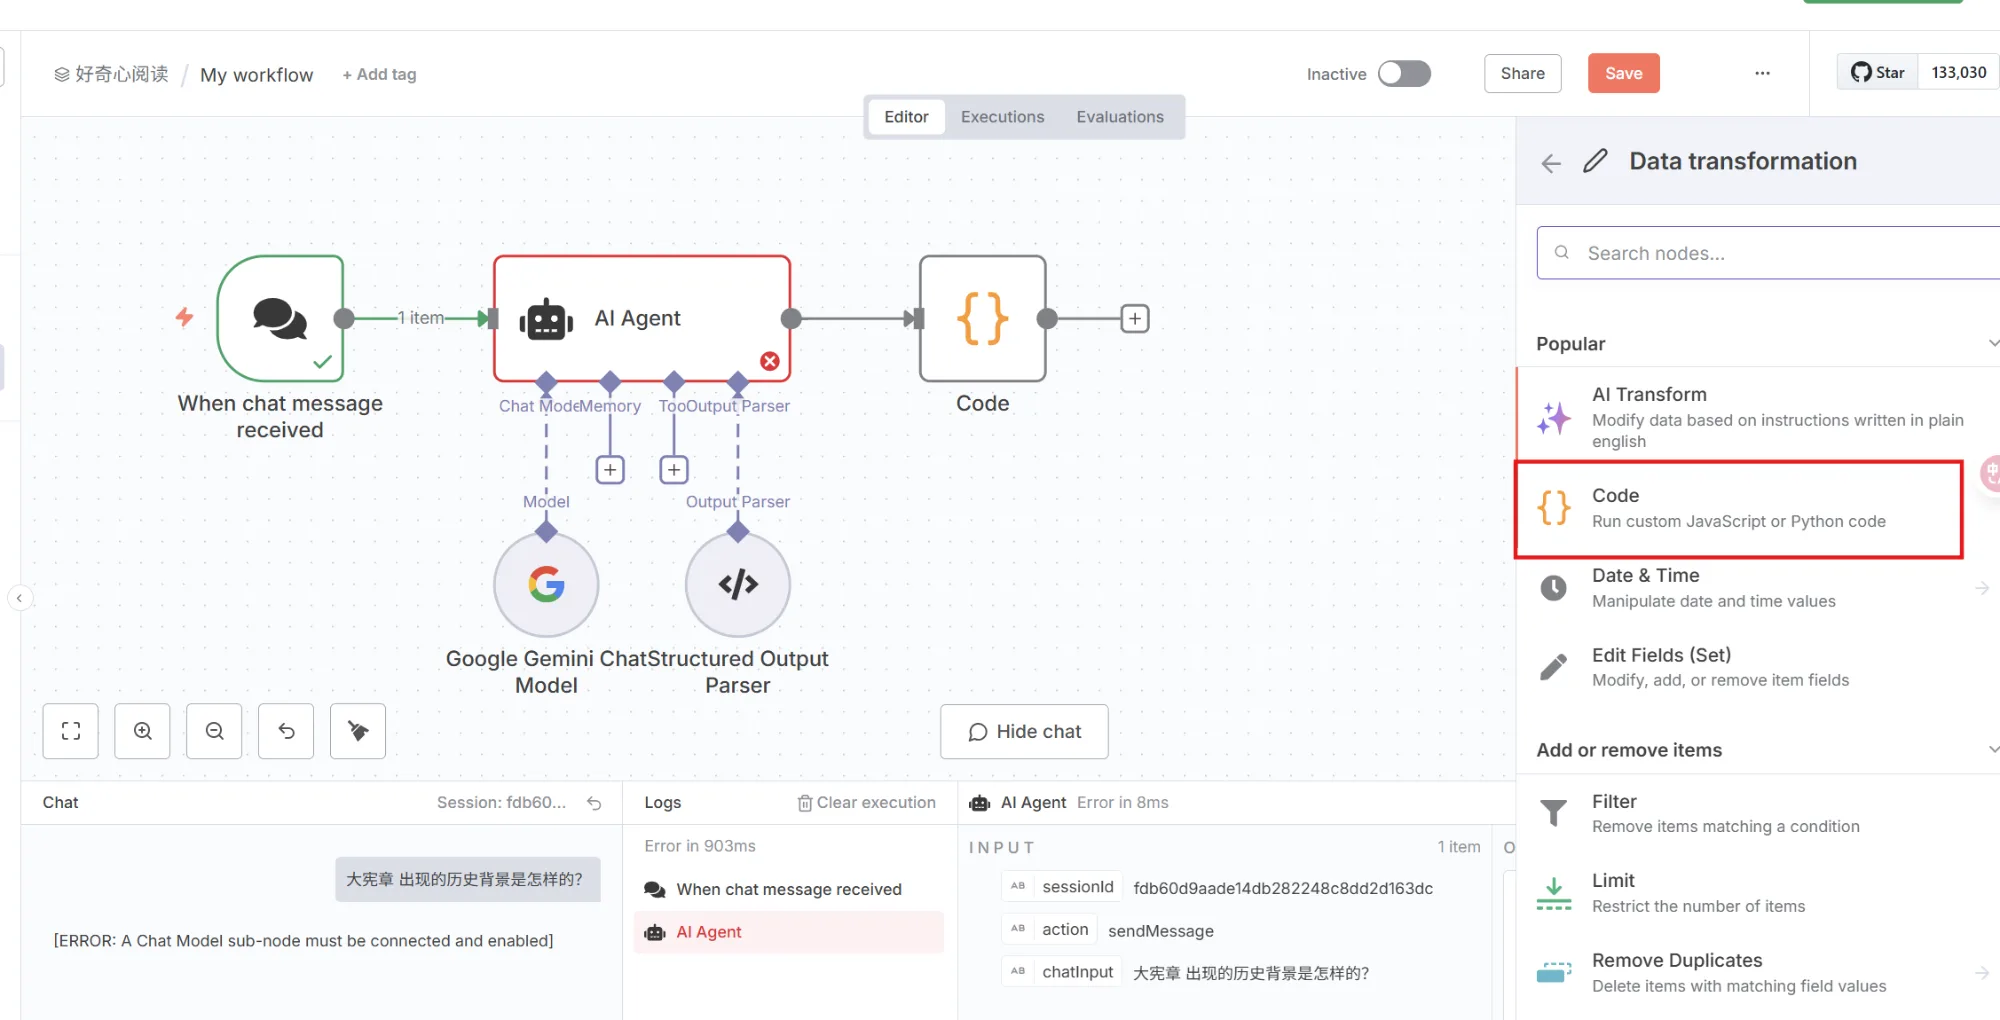
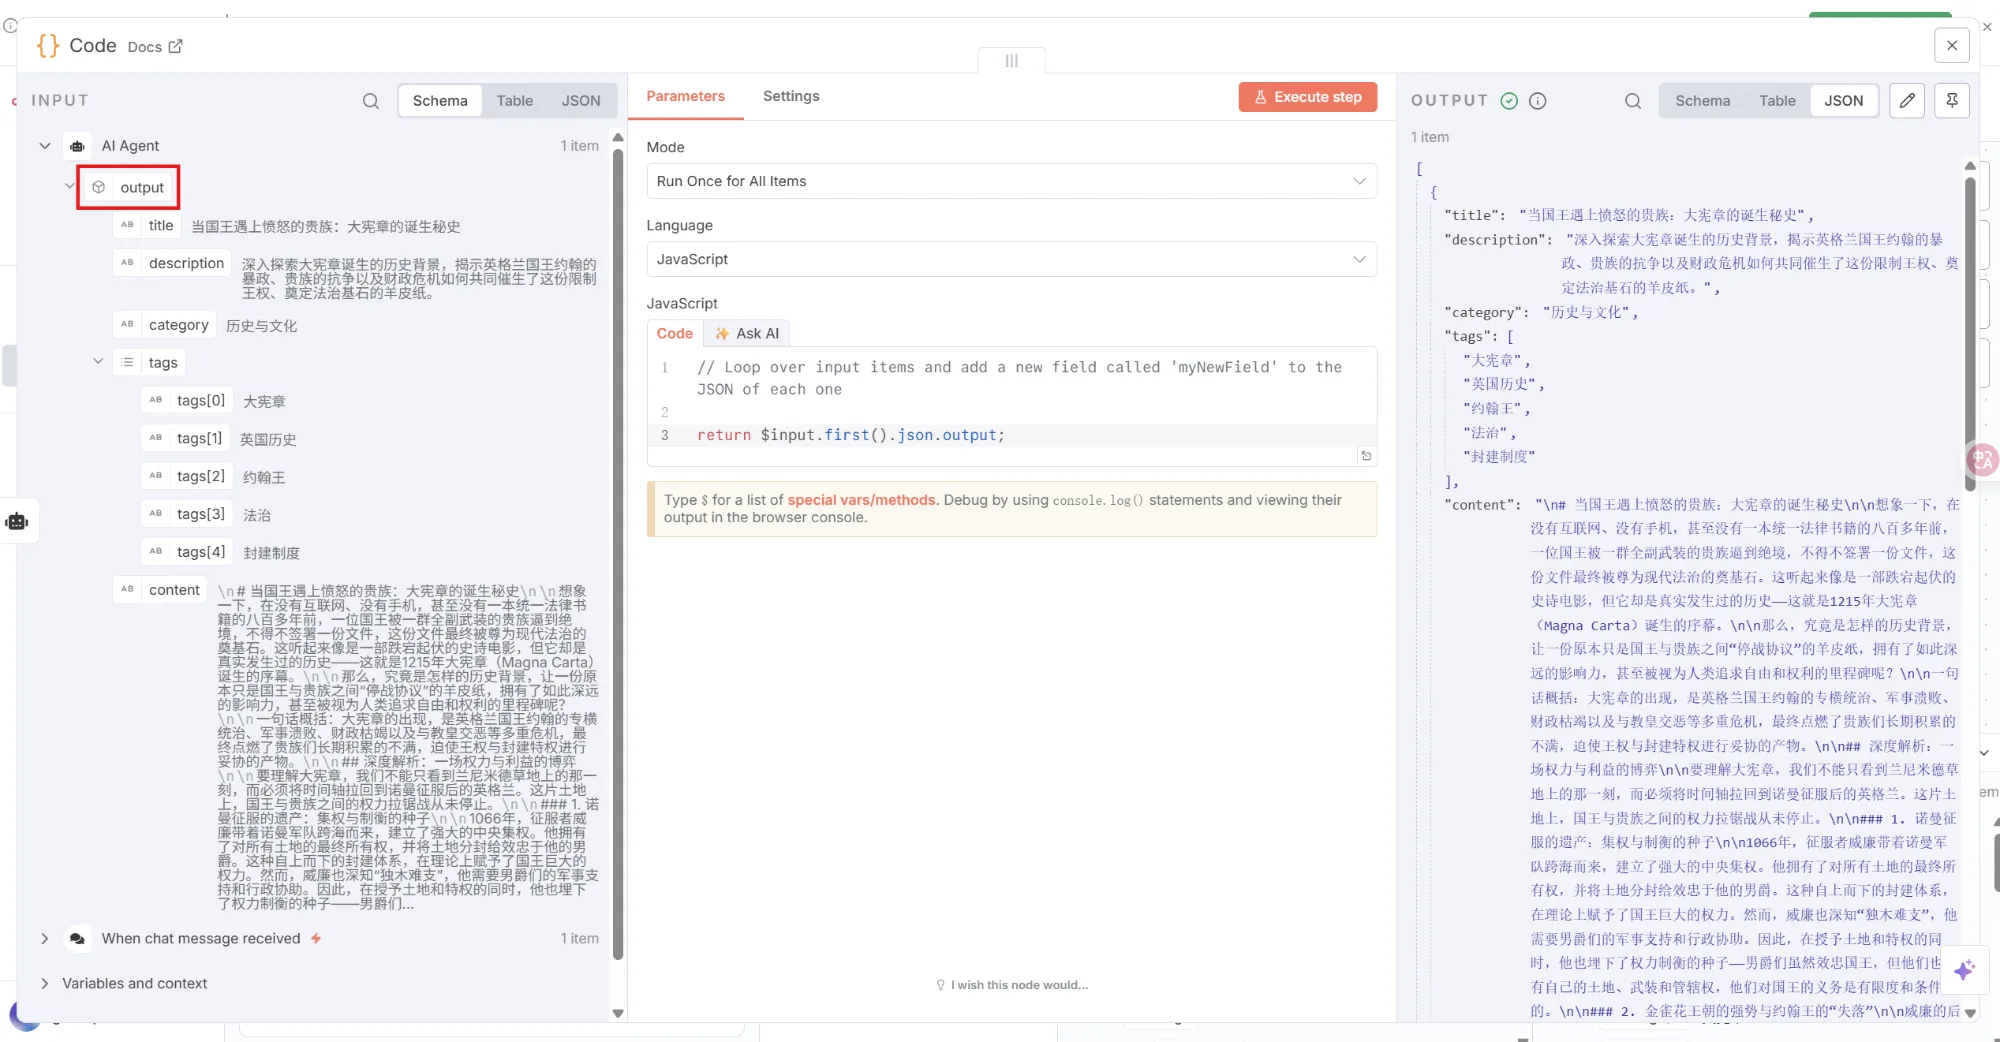
再创建一个 Code 节点,把 AI 输出的 JSON 取出来。这一步顺便补上一个 AI 不该决定、但数据库要求必填的字段:我的 posts 表里 type 是必填的,而且没有默认值。只把 title 和 content 交给 Supabase 节点,插入会直接失败:
// 模式:Run Once for All Items
return $input.all().map(item => ({
  json: { ...item.json.output, type: 'article' }
}))
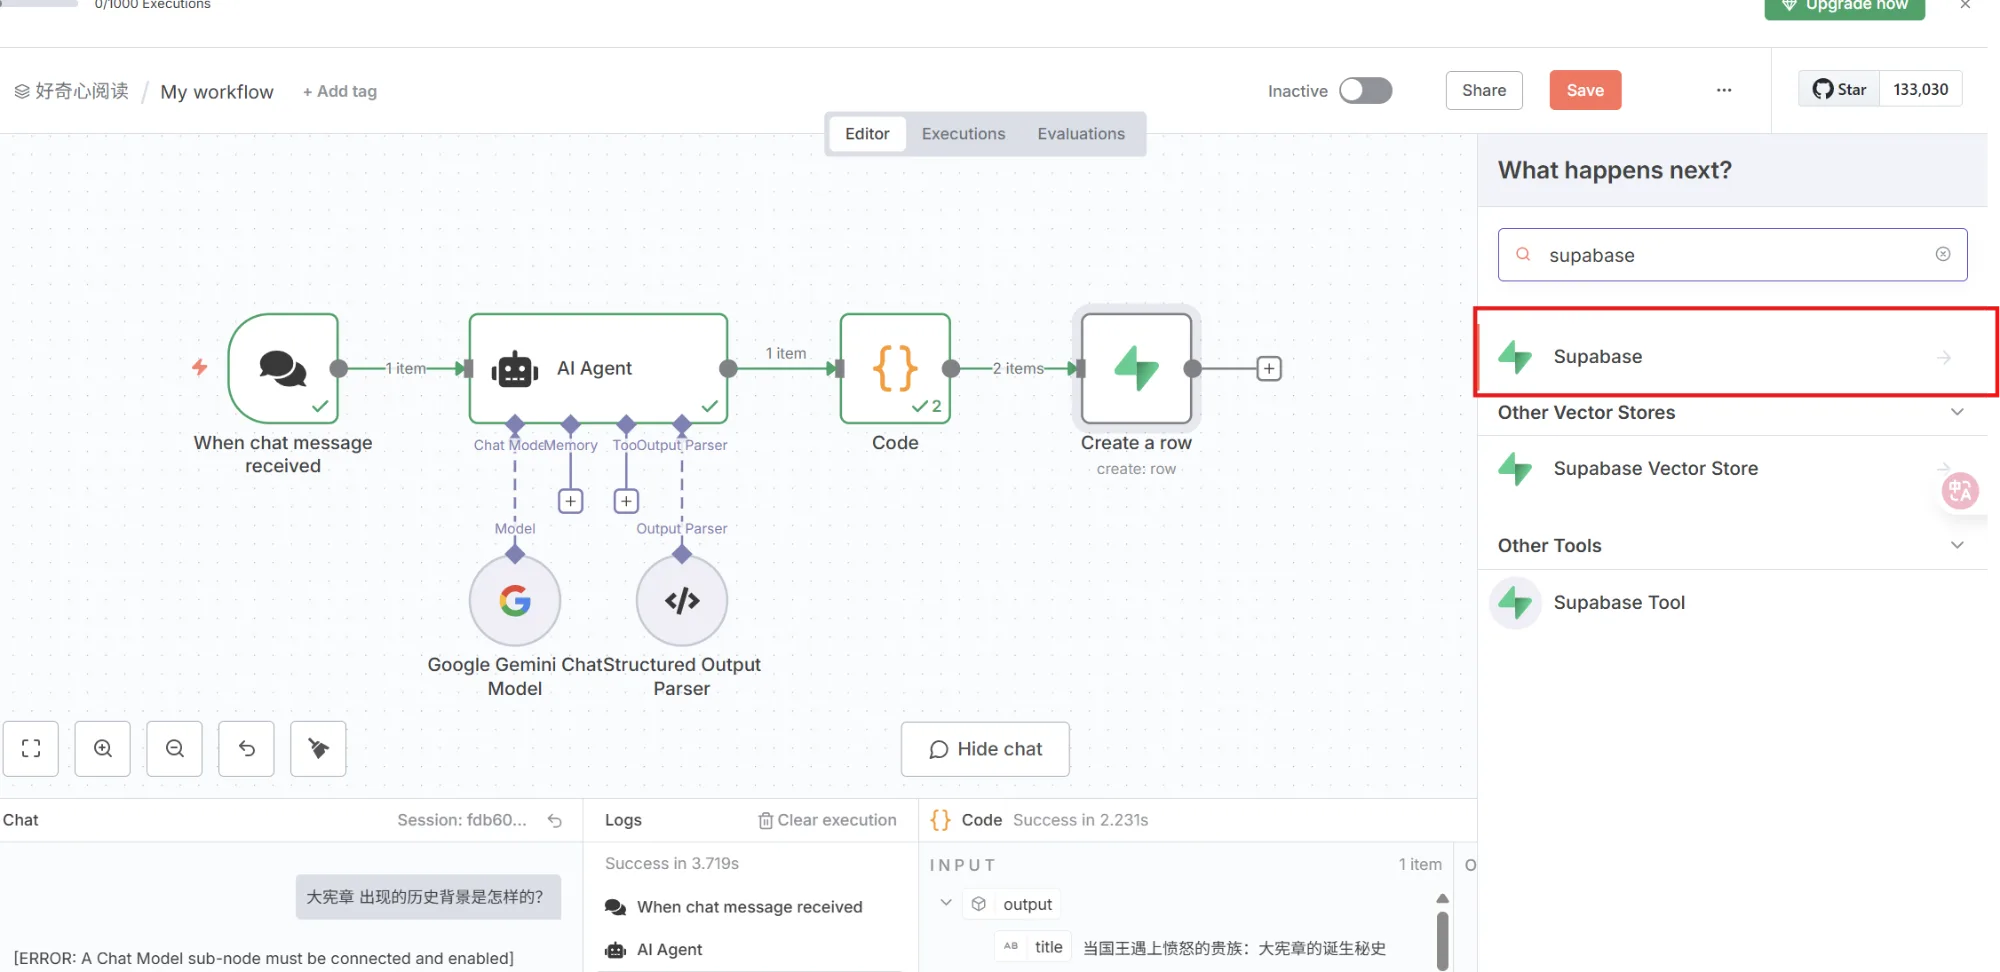
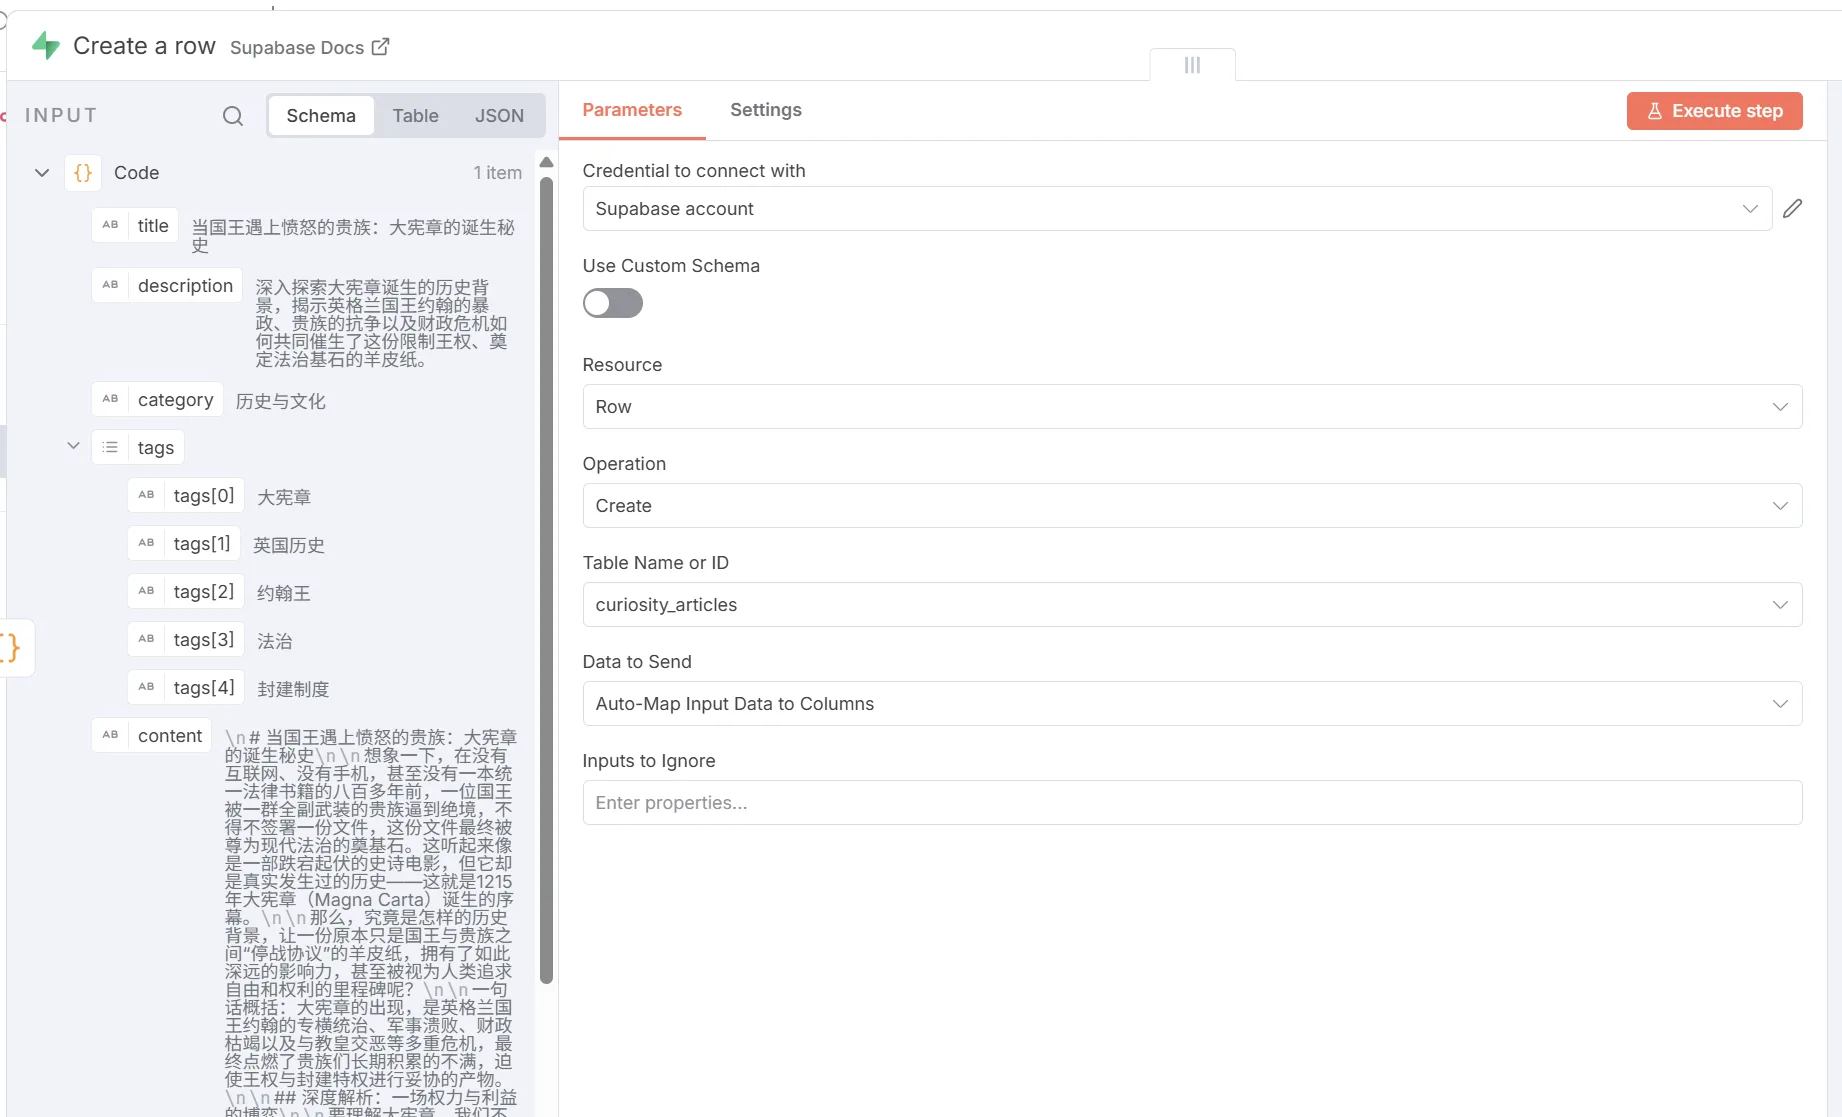
最后写进数据库。n8n 的 Supabase 节点可以直接操作表,JSON 的字段名和表的列名一致时会自动对应,不用一个个手动映射:
运行
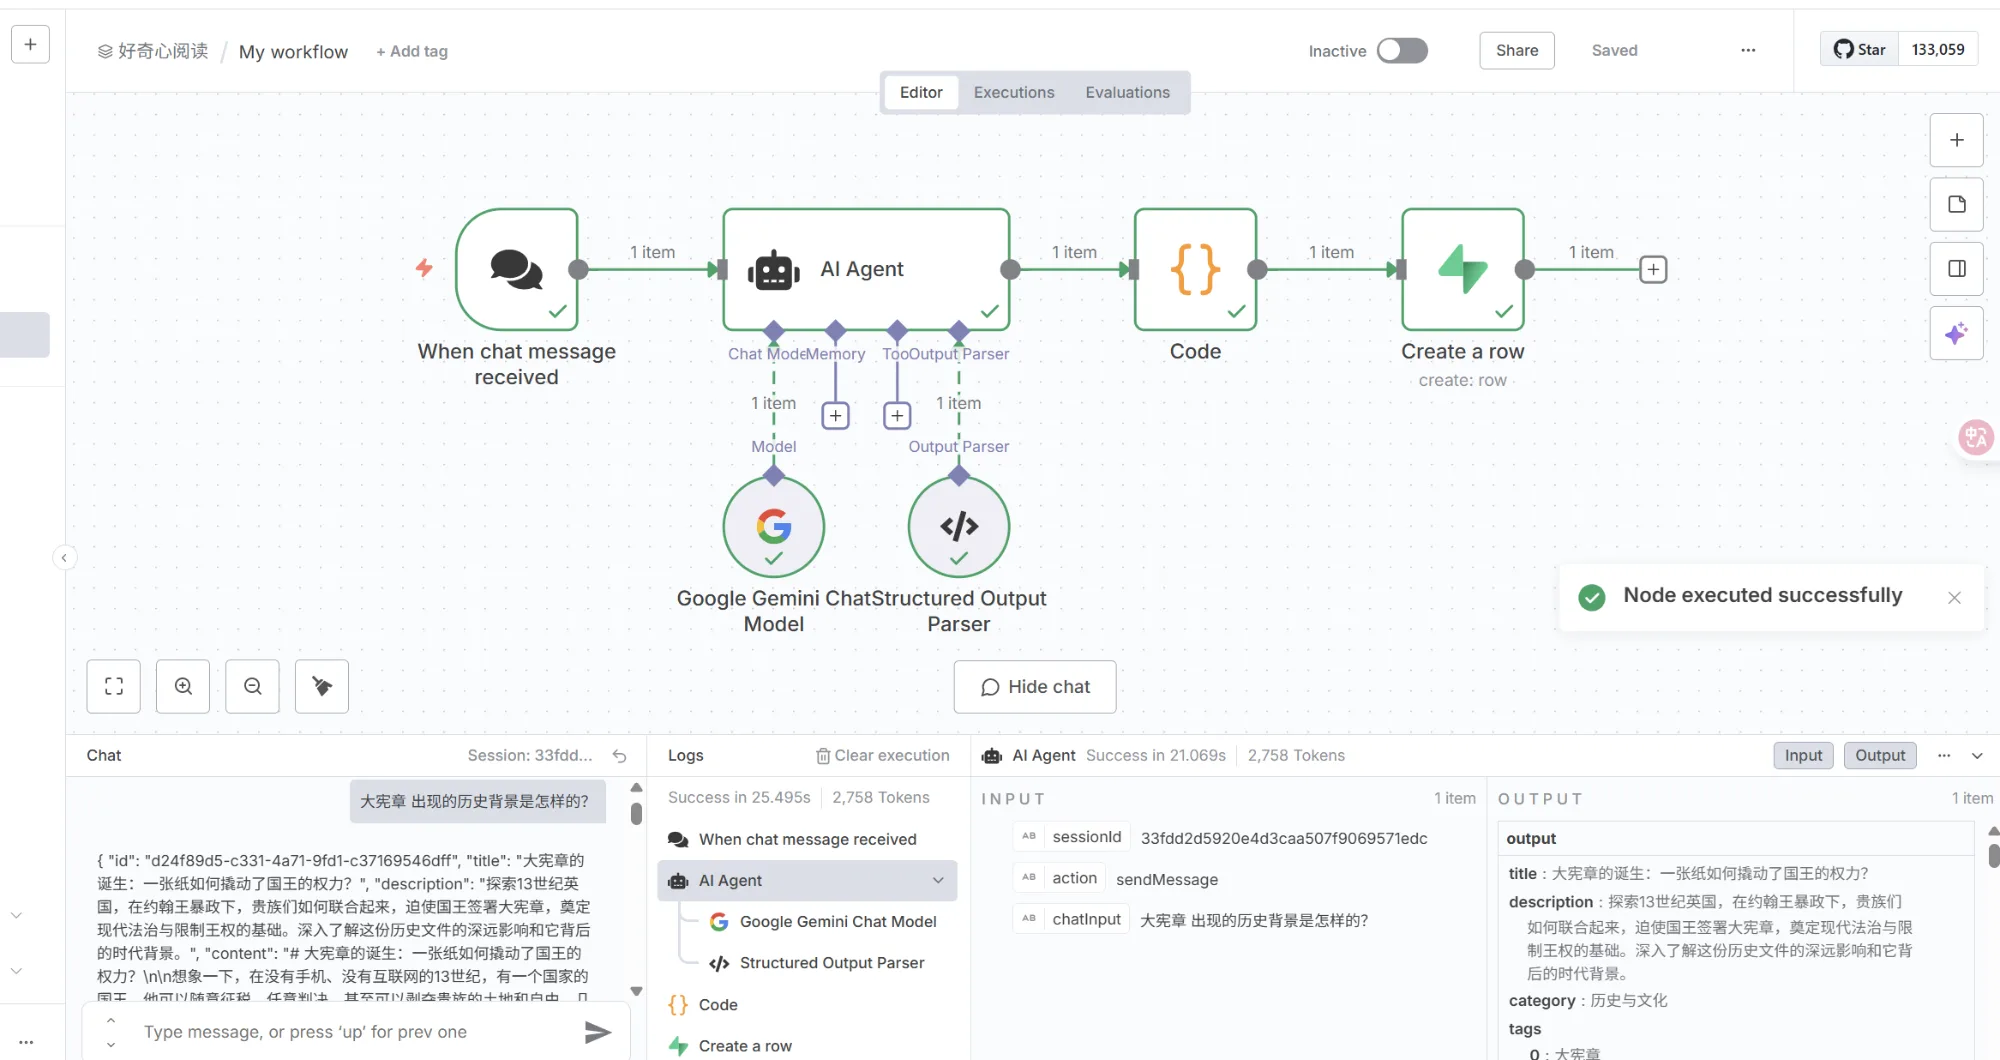
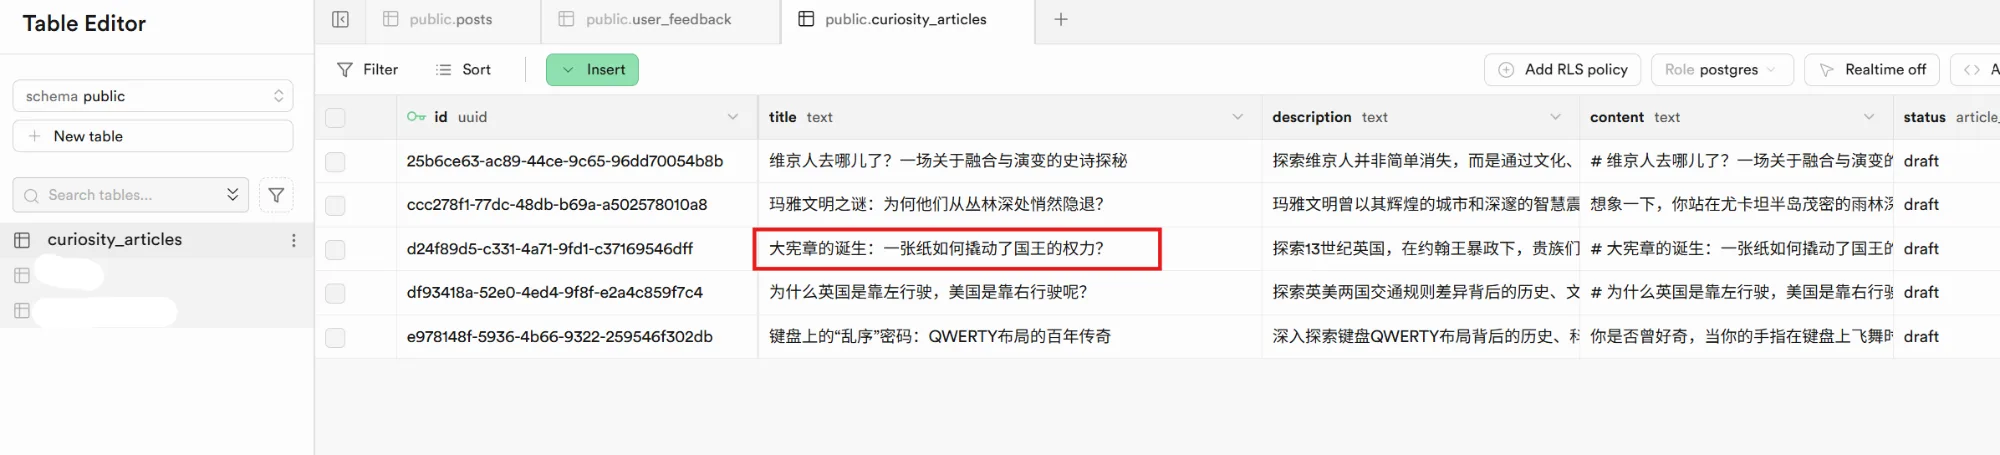
搭完之后,在对话框里输入一个标题,工作流会依次跑完每个节点,把生成的文章插进数据库:
踩过的坑
JSON Schema 要和表结构对齐。字段名对不上,Supabase 节点的自动映射就不生效,只能手动一个个对应。所以写 schema 之前,先把目标表有哪些列、哪些是必填的看清楚。上面 type 那个坑就是这么来的。
另外,生成出来的文章默认是不公开的:posts 表的 is_published 默认为 false。这正好符合我的需要,AI 生成的内容先进草稿,我看过、改过再发布。
现在
这个工作流我现在已经不用了。一是暂时没有批量产出文章的需求;二是这一年里,skill 加上各家 AI 厂商自己的 agent 工作流,抢走了很多原本属于 n8n 这类工具的场景。